一、文章总览(按发表时间)
二、主题索引
AI 价值链经济学 :#3 MANG → #4 生成式 AI 经济学(2024)→ #20 两年之后(2026)→ #22 斯坦福课程总结消费级 AI 数据分析 :#5 (2024 年判断 Meta/Google 会赢)→ #16 / #17 / #19 (2026 年三部曲,公开承认判断错误,ChatGPT 一家独大)→ #18 播客AI Agent 与 FDE 模式 :#7 Palantir 文化 → #9 自动驾驶 vs 数字 Agent → #11 OpenAI 的 FDE 手册投资备忘(Altimeter 出手的公司) :#6 Glean、#12 Revolut、#14 Parloa、#15 / #21 Baseten早期作品(2016) :#1 Amy Ingram、#2 深度学习 101其他 :#8 Neuralink、#10 AI 音乐版权、#13 年度预测与对账三、贯穿全博客的核心观点(编者归纳)
AI 价值链倒挂 :半导体层(主要是 NVIDIA)拿走约 70–80% 的营收和毛利,与云时代应用层拿大头正好相反。作者一直预期终将翻转,但 2026 年的更新判断是"可能超过十年"。消费级 AI 呈幂律集中 :ChatGPT 约占 70% 份额,且参与度、留存、时长都在同步改善。作者公开承认 2024 年"分发为王,Google / Meta 会赢"的判断是错的。推理(inference)将成为最大的市场 ;后训练的开源模型在成本 / 控制上胜出,"学习闭环"成为企业新的 IP。FDE(前线部署工程师)模式 是让新技术在企业里"真正跑起来"的关键,源自 Palantir,OpenAI、Parloa、Baseten 都在采用。广告可能比订阅更大 :ChatGPT 的高意图对话流量若按每位免费用户每年 30 美元计,约对应 250 亿美元广告收入。
№ 01 2016-03-29 1,522 词
Amy Ingram 产品评测
Amy Ingram — a product review
阅读英文原文 ↗
背景
Amy Ingram 是 x.ai 开发的日程安排软件,作者称其"可能是第一款 100% 由 AI 驱动的实用软件"。文章是作者的试用笔记,并向工程团队提交了改进建议;文中还穿插"这是人写的还是机器写的"的问题,让读者思考人机边界。
安装与设置
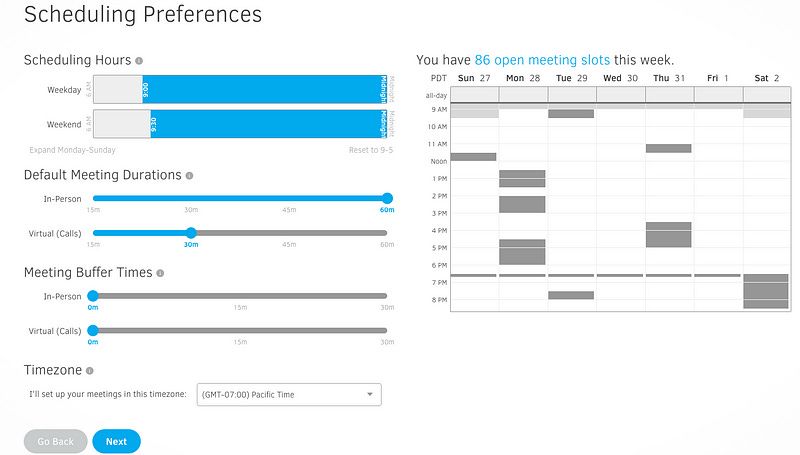
无需安装、无账号密码。作者 2016 年 1 月 29 日申请测试,3 月 23 日获邀。设置项包括:日历(作者接入 Google Calendar)、日程偏好(面谈需 1 小时加 15 分钟缓冲,电话 30 分钟)、邮箱、联系方式(电话、Skype)、会面地点偏好(早午餐 / 咖啡在办公室,晚餐在家附近)。
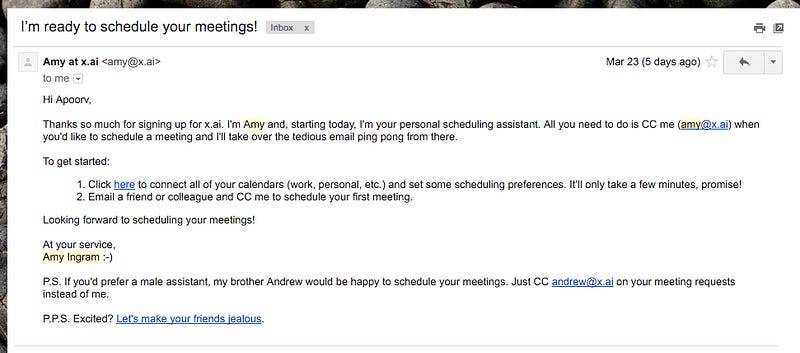
原文配图 Welcome email原文配图 Example of a setup screen功能
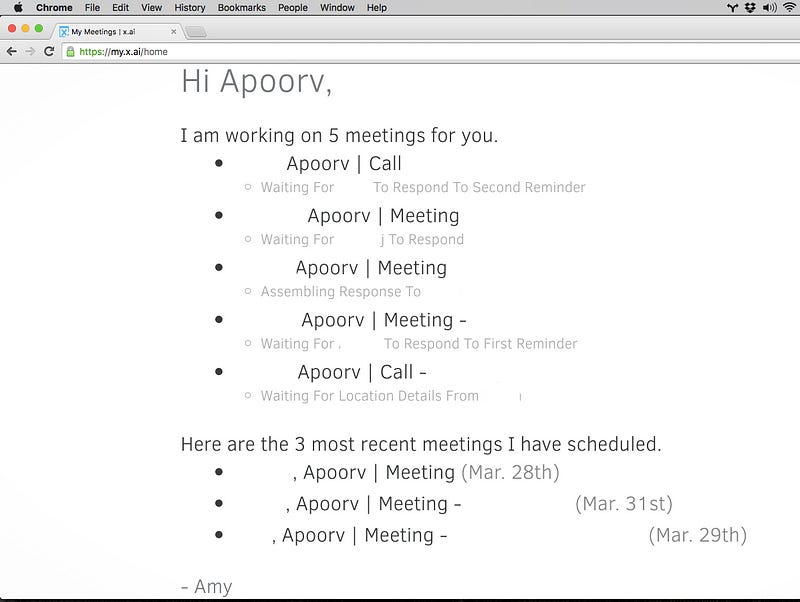
把 Amy 抄送进邮件线程,她接管后续沟通(用户被移出对话),双方敲定时间后自动发送日历邀请。对方常误以为她是真人,直到看见签名里的说明。网站上可查看所有在办事项。
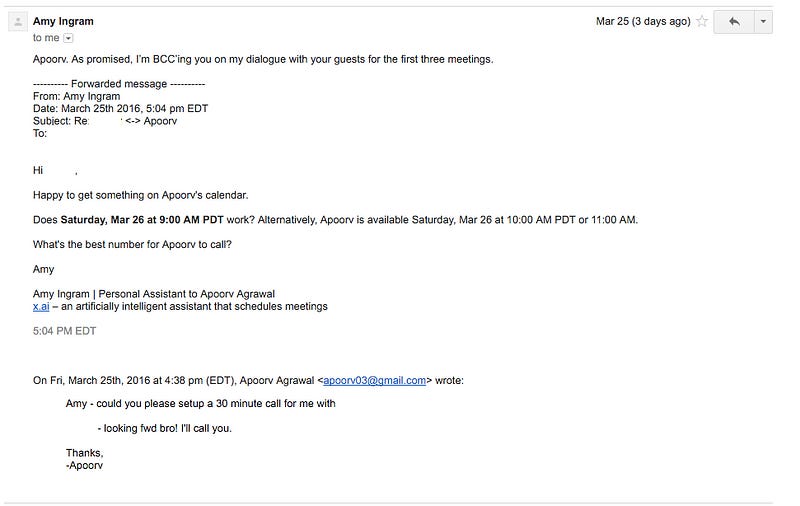
原文配图 Cross section of things Amy is helping you with at any time (names hidden)原文配图 Amy 给对方的回复示例(姓名已隐藏)当前版本缺失的功能(7 条) :
不发送时区敏感的时间。这是作者最大的痛点,因为多数请求是跨国通话。合理的限制是 Amy 无法知道对方时区;次优方案是允许用户告知对方时区。 不接受时区敏感的回复。她提 9am PT,纽约的对方回"12pm ET 可以"会让她困惑;但若对方要求她按 GMT 给时间,她能正确换算。 改期麻烦。邀请由 [email protected] 拥有,用户自己无法拖动,只能写信等她调整,不像软件应有的即时性。 不支持周期性会议。 无法看到或干预 Amy 与对方的对话,例如想告诉她"这只是个电话,不必找场地"。 只给几个候选时段而非开放时间块。建议发一个指向最新日历的动态链接让对方自选(有工程取舍)。 以邮箱地址作为唯一标识。同一人有多个邮箱时,Amy 会试图组织一场多方电话会议。 支持与隐私
作者向 Amy 发了一个简单的支持问题,收到一封措辞得体的回复,解释她为何不在日历上放 tentative hold、并承诺时段失效时会重新协调。作者怀疑这是人工回复。若属实则是隐私问题:用户以为没有人会读邮件内容,信任已被打破。建议 Amy 在无法回答时透明地说明,并请求授权后再转交工程师。
表现数据
11 个请求中完成 9 个;9 个中 3 个完美安排、3 个需要作者干预、3 个因对方两天未回复而取消。
结论
Amy 有效且极具亲和力,作者和对方都至少一次忘记她是软件。如同 Amazon 重塑实体书店,在线日程安排也将被软件重塑。
№ 02 2016-11-23 2,624 词
深度学习入门 101
Deep Learning 101
阅读英文原文 ↗
问题
AI 的目标是在机器上重建人类智能,分解为三个原子步骤:接收输入(视频、图像、声音、文本,未来或有嗅觉)→ 理解(人脑用不同区域处理不同感官信号,机器用为视觉 / 语音 / 文本各自优化的 GPU 或超算)→ 行动(根据路况开车)。以"接球"为例:图像经视网膜初步分析送入视觉皮层,再送往全皮层与已知一切比对、分类、预测轨迹、决定抬手接球。这一切在几分之一秒内几乎无意识完成、几乎从不失败,在机器上复现却是一组相互依赖的难题。
解法:深度学习
深度学习是一种特定的机器学习技术,即多层人工神经网络(ANN),擅长学习模式并据此分类或预测。ANN 由 Frank Rosenblatt 于 1957 年提出,节点(带激活函数)通过带权重的边连接;超过 3 层即算"深"。简单模式识别可用逻辑回归或 SVM,中高复杂度问题深度学习全面胜出。模式经输入层进入隐藏层处理;ANN 能把大模式拆成小模式,例如先找水平 / 垂直边缘再识别人脸。可在 TensorFlow Playground 和 Clarifai 的演示中体验。
原文配图 Example of an ANN on Tensor Flow三大基石
数据规模 :越多越好。Google 2015 年人脸识别用了约 2.6 亿张图。多数实际问题需要 1 万到 10 万个数据点;数据不足时可微调强预训练网络,或做数据增强(裁剪、镜像、旋转)。无论何种算法,数据越多表现越好。原文配图 Courtesy Dr. Andrew Ng’s course on ML计算硬件 :AI 的价值来自经验性实验,迭代速度决定能试多少想法。Andrew Ng 团队从普通神经网络试到循环神经网络(RNN)才做出 Deep Speech。路径是 CPU → GPU → 云 → HPC;ANN 核心是线性代数,天然可并行,因此 NVIDIA 的 GPU 成为标配;高性能计算把实验周期从数周缩到数天,一年可试数百个想法。原文配图 从普通神经网络到循环网络:Deep Speech 的演进示意特征表示算法 :每个节点做非线性计算(sigmoid、tanh、ReLU)。最佳特征表示和损失函数是数千名研究者数十年的积累(计算机视觉的 SIFT 花了十年),现已被抽象封装。不同任务对应不同架构:无监督学习用 RBM、自编码器;文本用 RNTN;图像用 DBN、卷积网络;语音用循环网络;通用分类用 ReLU;时序分析用循环网络。为什么这么火
2012 年起 ML 准确率从约 74% 跃至 84%,行业以前所未有的速度投入硬件、软件、数据和资金。四个推动因素:传感器无处不在带来的海量数据(Facebook 2014 年用 440 万张、Google 2015 年用 2.6 亿张图训练人脸识别);GPU / HPC 及正在探索的专用硬件;算法改进;资本投入与并购。
应用
深度学习已是几乎所有计算机视觉(人脸识别已超过人类)、语音识别(Siri、Alexa)和自然语言处理任务的最先进方法。应用步骤:选框架(Caffe、TensorFlow、Torch 7、Theano / Keras / Lasagne、MatConvNet)→ 用 GPU 或云资源(AWS、IBM Softlayer)。用途包括机器视觉、视频识别(防盗、自动驾驶)、语音、文本处理(信息抽取、翻译、情感分析、配图说明)、医疗(癌症早筛、药物发现)、放射科(良恶性肿瘤分类)、金融、数字广告、欺诈检测、营销、农业、博弈(AlphaGo)。
作者眼中的下一波
生成式学习 :不只回答问题,而是让机器学会提出正确的问题,具备上下文和意图的理解(例如波士顿和旧金山的无人驾驶 Tesla 应有不同)。当前 AI 多为任务驱动,通用 AI 意义上的理解尚无进展。芯片设计(ASIC / FPGA) :越专用越高效,但失去可塑性。理想的深度学习硬件要"既能专用又能变形",即新型神经形态硬件;且硬件只是一半,真正的变革是软硬件一体的平台,让人像跑 Python 或 C++ 一样在其上开发应用。值得关注的公司(2016 年视角)
医疗:Sano(血液生物标志物持续监测)、Enlitic / MetaMind / Zebra Medical(影像决策支持)、Deep Genomics / Atomwise(基因变异与药物重定位)、Flatiron Health(肿瘤数据基础设施)、Google 无针采血专利。 企业自动化:SigOpt、Arimo、Ditto Labs、Nervana、Databricks。 视觉与语音:Comma.AI、Affectiva、Gridspace。 安全:Deep Instinct。 附录给出梯度下降、反向传播、卷积神经网络、深度信念网络、受限玻尔兹曼机、深度强化学习等术语的简要解释。
№ 03 2024-01-18 1,087 词
新晋 VC:“MANG”
New VC in town: “MANG”
副题:MANG VC 的崛起对创业者意味着什么?
阅读英文原文 ↗
#1 认识 MANG
2023 年 MANG 参与的融资总额超过 250 亿美元,约占北美 VC 总额的 8%;其中 230 亿集中在数据与 AI,约占该领域全部融资的 30%。
原文配图 Source: Pitchbook原文配图 Source: PitchBook#2 需求侧:投资客户
原文配图 Source: PitchBookChatGPT 之前 MANG 投出行(Waymo、Cruise、Rivian、Uber),之后投大语言模型(OpenAI、Anthropic、Inflection、Adept、CoreWeave)。LLM 公司是最大的算力买家,云厂商投资客户的钱会以营收形式回流。据 Semafor 报道,微软对 OpenAI 的 100 亿美元中只有一部分是现金,相当部分以云算力形式分期交付。作者的算例:假设一半、两年用完,则第一年为 Azure 带来 25 亿营收,按约 6 倍软件营收倍数对应 150 亿企业价值。"100 亿换 150 亿加股权",而传统 VC 只是"100 亿换股权"。撇开 Bill Gurley 对收入确认的质疑,这对 MANG 显然是净现值为正的投资。
原文配图 Bill Gurley 关于收入确认的推文作者预计未来 24 个月 MANG 的投资额维持在 VC 总额的约 5%(2023 年之前为 1–2%)。
这种"投资客户"的模式并不新(Illumina 对分拆公司、Palantir 对客户 SPAC 都做过),但对 VC 提出了问题:MANG 定价的轮次,其估值代表什么?财务投资者该不该跟投?早期 VC 是否希望被投公司拿 MANG 的钱?
#3 供给侧:印钞的数字收费站
MANG 已演变为现代数字收费站。每个新的数据或 AI 项目启动,收银机首先在超大规模云厂商响起;客户付给 LLM 提供商(如托管在 AWS Bedrock 上的 Anthropic)的每 1 美元推理费,作者估计超过 50% 流向云厂商。MANG 2023 年合计营业利润 2,760 亿美元,十年增长约 5 倍;合计资本开支 1,080 亿美元,十年增长约 12 倍。
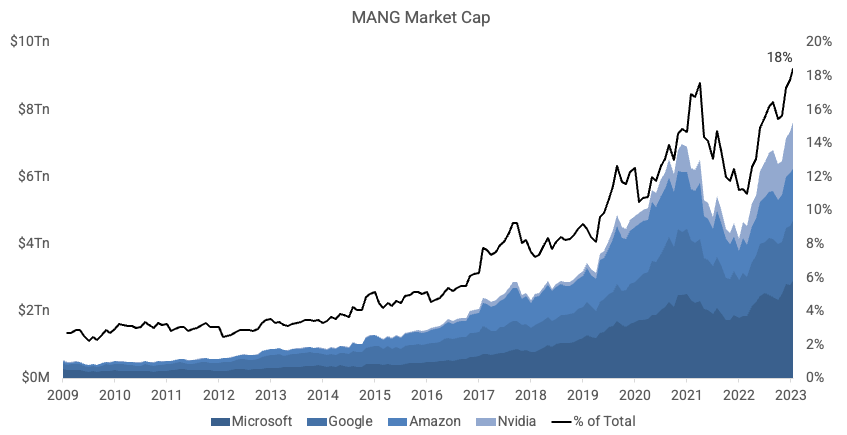
原文配图 Source: CapitalIQ原文配图 Source: CapitalIQ投资"吃基础设施"的初创公司可确保云服务的最优利用率、降低巨额资本开支的风险。MANG 合计市值 7.6 万亿美元(占美股 18%),2010 年仅 4,800 亿美元(3%),13 年增 16 倍。
原文配图 Source: CapitalIQ, FRED, Ycharts#4 对创业者意味着什么
利 :
更低成本的资本:战略契合时可拿到更大的轮次、更少的稀释;但高估值未必是好事(引 HBO《硅谷》的梗)。 共享 GTM:借用 MANG 的销售团队是多数创业者的梦想,但实践中是否有人真正成功?要分多少经济利益?收入高度集中于单一云意味着什么? 接触前沿模型与团队:模型层非核心能力时尤其有帮助。 弊 :
疏远客户:拿了某一家的大钱几乎必然绑定其基础设施,会失去建在其他云上的客户;例如企业只能通过 Azure 使用 OpenAI。竞争对手视角的客户或伙伴也可能因此却步。 多轮融资动态:下一轮 MANG 还会在吗?战略方定的价格财务方接不接? 股权结构:若计划上市,大战略股东可能对股票形成负面信号;理想的大股东是提供长期稳定资本的财务投资者。 激励错位:MANG 不是纯财务投资者,可能阻挠对财务有利但不符合其战略的并购或融资。
№ 04 2024-04-25 1,308 词
生成式 AI 的经济学
The Economics of Generative AI
副题:半导体层拿走了今天约 90% 的生成式 AI 利润!未来价值流向何处,如何到达?
阅读英文原文 ↗
#1 价值目前积累在哪
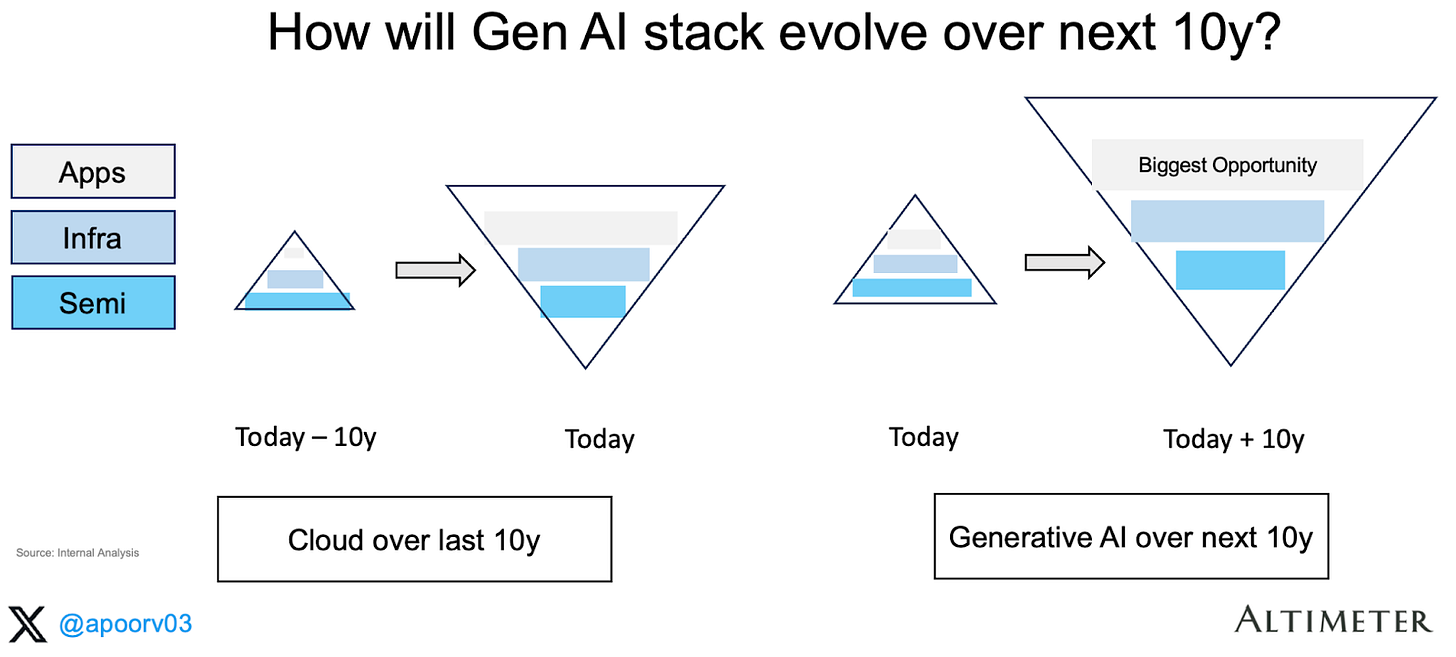
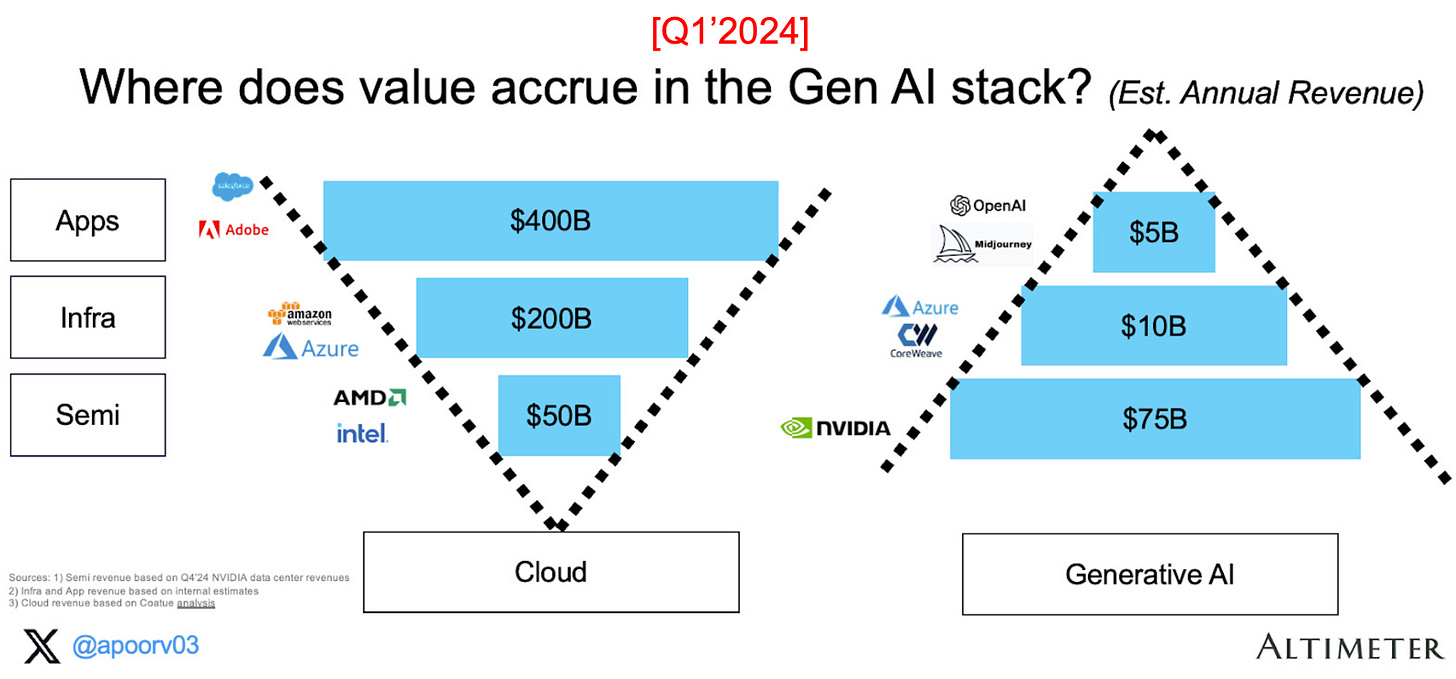
距离"AI 的 iPhone 时刻"(Jensen Huang 语)已 18 个月,节奏未减。作者把堆栈分为半导体、基础设施、应用三层,生成式 AI 的堆栈呈 A 形,而云是 V 形。
原文配图 生成式 AI 堆栈(A 形)与云堆栈(V 形)的营收分布年化营收估算:
半导体约 750 亿美元:NVIDIA 上季(2024 年 1 月止)数据中心营收 180 亿,市占 95% 以上。 基础设施约 100 亿美元:AWS、GCP、Azure 及 CoreWeave、Lambda 等推理云,已是慷慨估计。 应用约 50 亿美元:OpenAI、Anthropic、xAI 等大语言模型,Midjourney 等图像模型,以及纯生成式 AI 应用;部分收入可能被计入"软件"收入。 结论:半导体层占 900 亿总营收的约 83% ,而在云堆栈中半导体只占约 10%。
#2 利润积累在哪
原文配图 各层毛利率对比毛利率:应用约 50–55%(参考 Anthropic 的估计);基础设施约 65%(不含 GPU 折旧,含则降到 25–30%);半导体 85% 以上(NVIDIA 数据中心产品)。云堆栈中 Azure 约 63% 毛利。730 亿美元总毛利中半导体拿 640 亿,约占 88% (云堆栈中半导体仅占 5%)。
原文配图 营收 × 毛利率:毛利集中在半导体层原文配图 各层毛利占比#3 接下来怎么走
作者不认为倒金字塔会永远如此,预期应用层终将像云时代一样拿走同样高的份额。移动时代价值先在半导体、再基础设施、最后软件;云时代先数据中心建设,再云服务商崛起(AWS 2004 年起步,Amazon 自己 2010 年迁入,Netflix 2012 年加入)。生成式 AI 现在处于"第一局(半导体)",预计本十年末进入"第三局(应用)";因基数低,最大的开放机会在应用层。三个关键问题:
原文配图 移动浪潮中价值的转移:半导体 → 基础设施 → 软件原文配图 生成式 AI 的三局:半导体、基础设施、应用A)NVIDIA 能否维持 85% 以上毛利? 作者认为不能。引 SemiAnalysis:毛利已见顶,B100 及后续产品略低,H200 和 H20 也会压低 H100 毛利。领先指标:GPU 交期(当时约 6 周)、GPU 租赁价格走势。
B)云应用毛利 75–80% 而 AI 应用 0–50%,如何演进? 作者认为会改善,杠杆包括:更好的定价与价值对齐(重度用户目前甚至亏钱);自研芯片降低总拥有成本(Google、Microsoft、Amazon、Meta 都在做,既去掉利润叠加又能针对工作负载专用化);模型架构改进(状态空间模型适合长上下文如编码,JEPA 适合视频);模型成本下降(批处理、蒸馏、量化、混合专家),引 Bill Gurley 的观察。
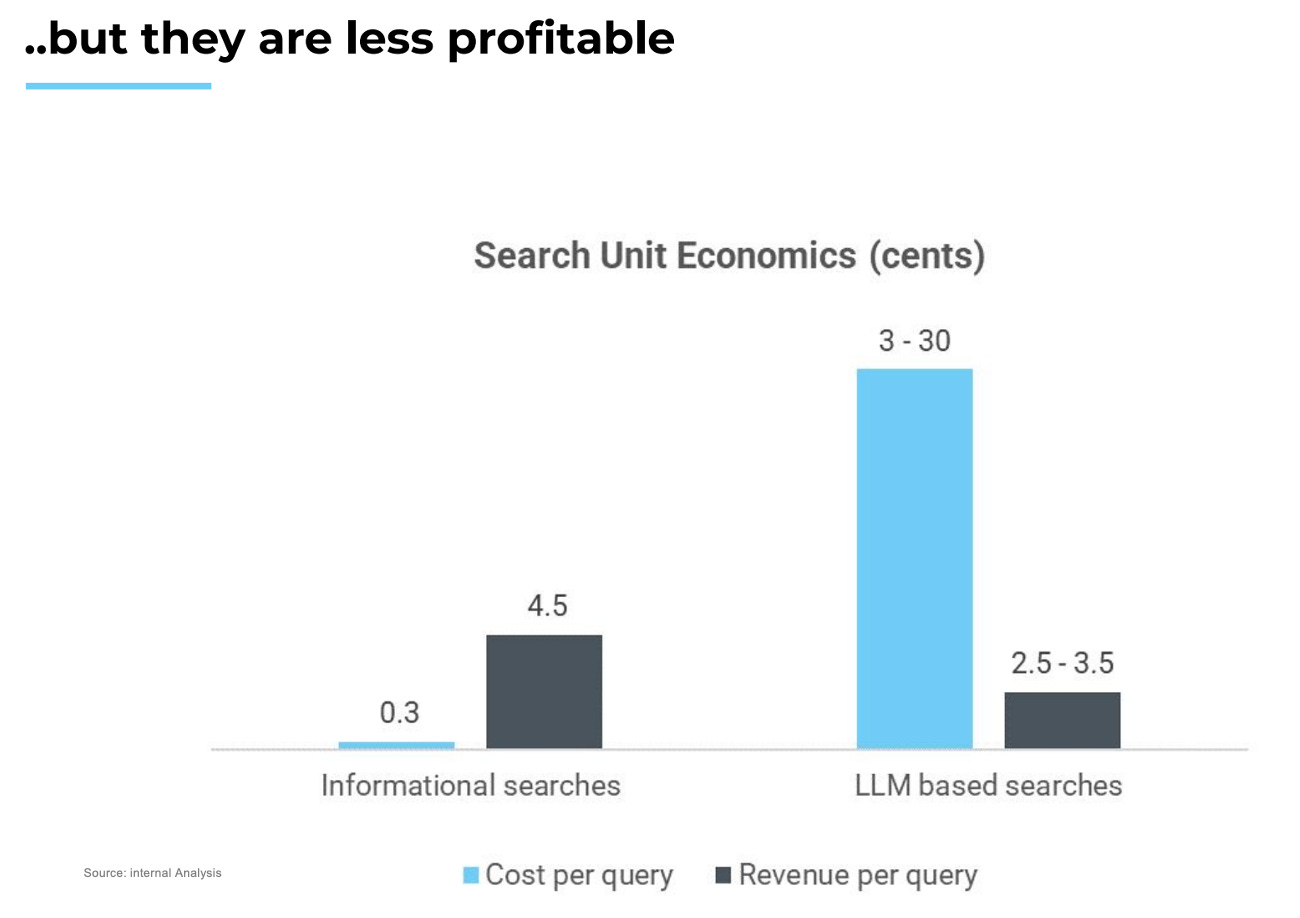
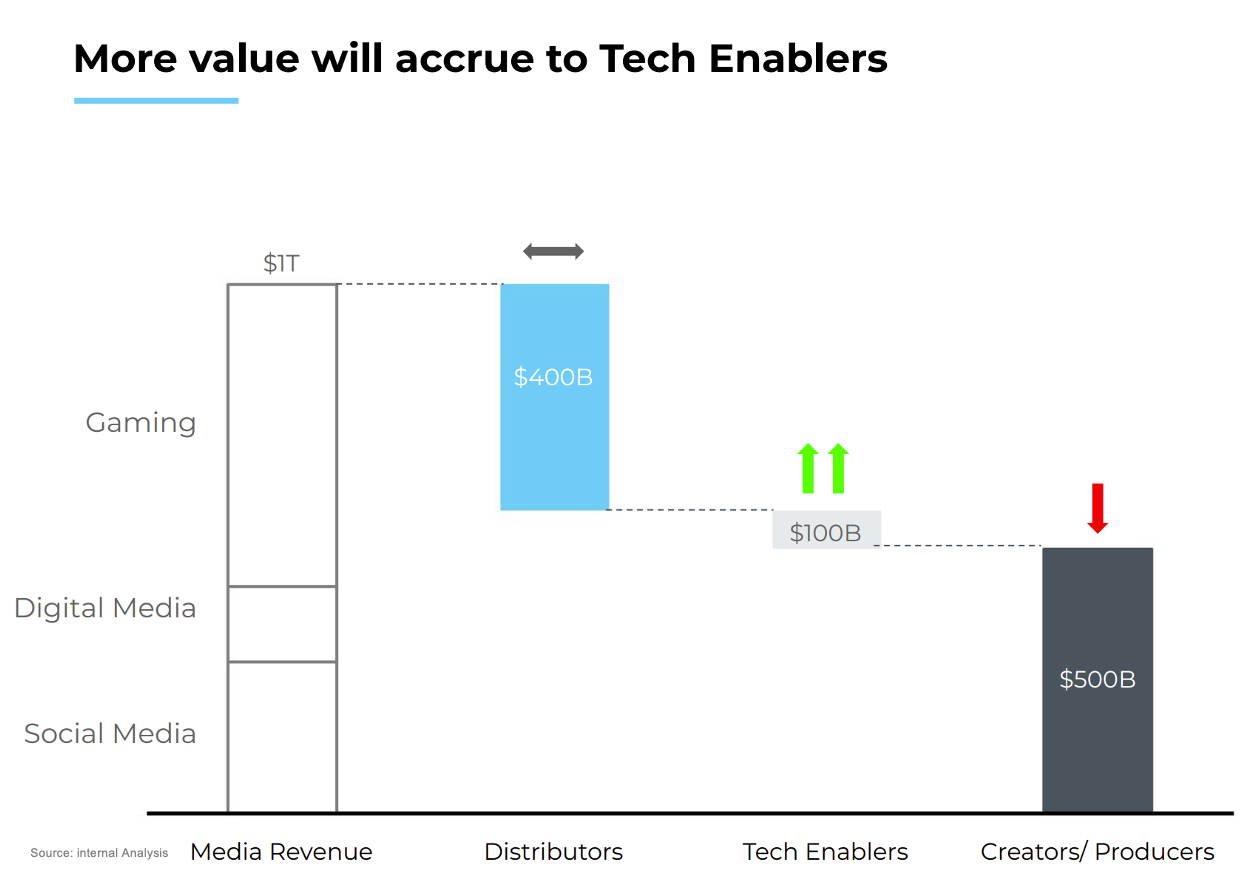
原文配图 Bill Gurley:模型成本快速下降C)消费级生成式 AI? 同样从硬件层开始,消费设备将升级为 AI PC、AI 手机或新形态(Meta 眼镜、Humane Pin、Rabbit R1)。消费应用分信息(搜索)、娱乐(游戏、媒体)、交易(旅行、电商)三段;搜索查询正从信息型转向 LLM 型;娱乐领域价值将从创作者 / 制作方转向技术赋能者(引同事 Vivek Goyal 的测算)。
原文配图 搜索查询从信息型转向 LLM 型(Vivek Goyal)原文配图 搜索查询从信息型转向 LLM 型(Vivek Goyal)原文配图 娱乐领域价值从创作者转向技术赋能者(Vivek Goyal)
№ 05 2024-08-09 2,149 词
为什么 Meta 和 Google 可能先于 ChatGPT 赢下消费级 AI
Why Meta & Google may win Consumer AI, before ChatGPT does
副题:消费级 AI 站在十字路口
阅读英文原文 ↗
BLUF · 一句话概要 用参与度、留存、时长三组产品指标对比,认为除非 OpenAI 彻底进化,否则拥有十亿级高参与度应用的 Meta 和 Google 将在本十年末主导消费级 AI。(编者注:作者在 2026 年的《消费级 AI 现状》系列中明确承认这篇的判断错了。)
引言
ChatGPT 是公认的杀手级应用,但到本十年末会是最广泛采用的 AI 应用吗?作者作为前 Palantir 产品经理,相信产品指标而非炫酷 demo。ChatGPT 的周活 / 月活比为 40%,对新产品很亮眼,但离十亿用户应用的 80% 相去甚远;Meta 和 Google 的 Instagram、WhatsApp、Gmail、Chrome 不只是应用,是"数字帝国"。
#1 参与度:用户有多离不开你
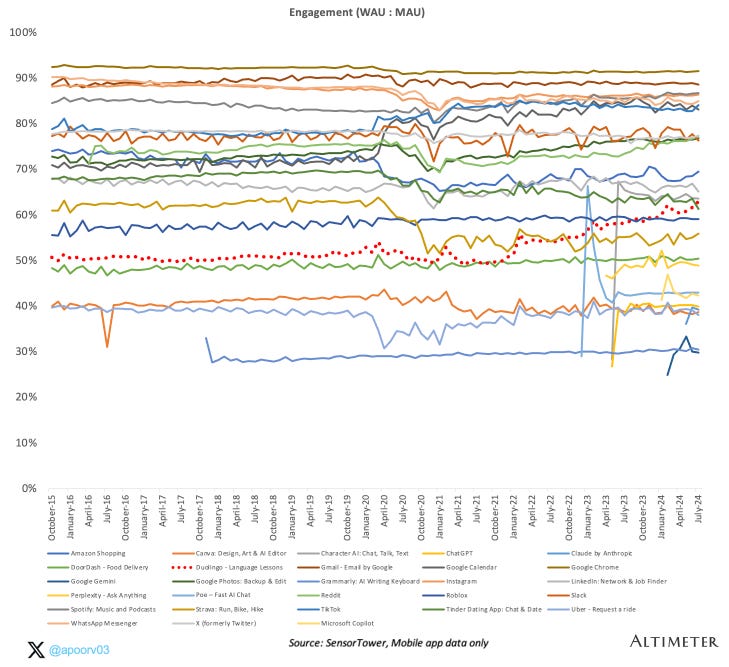
作者用 WAU:MAU(周活 / 月活)而非 DAU:MAU,以贴合工作周节奏、容纳知识工作中密集但零散的 AI 使用,并便于与企业软件比较。
原文配图 MAU 与参与度(WAU:MAU)散点图原文配图 各应用 WAU:MAU 对比发现:
十亿用户门槛:需要 80% 以上的 WAU:MAU。这个俱乐部包括 Instagram、WhatsApp、Gmail、Google Calendar、Chrome,全部属于 Meta 和 Google。 企业应用(Outlook、Teams、Slack)在 60–70%。 多数生成式 AI 应用含 ChatGPT 在 40–50%;Character AI 是例外,跳出了这个区间(刚被 Google 收编)。 Meta 和 Google 的分发优势:可以在现有"地盘"内嵌 AI。 ChatGPT 要到十亿用户需把 WAU:MAU 提到 80% 以上,但历史数据显示该比率极其稳定:十年间只有 Duolingo 和 Google Calendar 有温和提升。
原文配图 WAU:MAU 十年间的稳定性这说明参与度主要由品类和核心价值主张决定,难以靠加功能或营销改变。含义:ChatGPT 需把参与度翻倍以上,科技史上罕见;Meta 已在"十亿用户 + 高参与度"象限;Google 有双重策略(在 Chrome / Gmail 中嵌 AI,加上 Character AI 与 Gemini 的 AI 专长);未来可能属于深度集成进高参与度平台的 AI,而非独立 AI 应用。
#2 留存:ChatGPT 开始微笑
原文配图 各应用首月留存率原文配图 采用量与留存对比首月留存:WhatsApp 90%、Instagram 90%、Chrome 89%、Gmail 75%、ChatGPT 66%。ChatGPT 对新品而言相当不错,可比部分企业应用,但仍落后顶级消费应用。留存曲线有三种形态(引 Sequoia):走平(核心用户找到持续价值)、下滑(持续流失)、微笑(罕见且珍贵,流失用户回流)。
原文配图 三种留存曲线:走平、下滑、微笑0–10 个月数据:Chrome 和 Gmail 呈微笑曲线;WhatsApp、Instagram 高且稳;ChatGPT 是数据集中第三个呈微笑曲线的应用 ,虽不如 Google 的明显;其他 AI 应用留存下滑更陡。
原文配图 第 0 到第 10 个月的留存曲线结论:Google 和 Meta 优势稳固,但 ChatGPT 的微笑曲线说明 AI 原生公司不可小觑,关键在于弥合"有前景的技术"与"根深蒂固的习惯"之间的差距。
#3 时长:注意力不是你所需要的一切
原文配图 各应用每周使用时长原文配图 使用时长对比TikTok 居首,Meta 的 Instagram、Facebook 强劲;Google 系(YouTube、Chrome、Gmail)合计可观;Character AI 时长可比部分社交平台;ChatGPT 作为工具型产品时长尚可,且同比翻倍,从每周 13 分钟到 26 分钟。注意时长受商业模式影响:广告模式天然激励时长,付费或交易型应用追求高效完成任务。含义:Meta 和 Google 的应用已占据大量用户时间,嵌入 AI 更易捕获持续注意力;AI 原生公司要么打造出色的独立体验,要么与已占据注意力的平台结盟。
#4 综合
Meta 和 Google 在参与度、留存、时长份额、分发、网络效应五方面占优。Meta 的秘密武器是 Zuckerberg"快速跟进复制"的作风。OpenAI 仍在推进技术边界,作者对其重大产品升级保持乐观,但当前优势属于已经主宰我们数字生活的巨头:"他们有主场优势"。
№ 06 2024-09-10 1,044 词
Glean:让 AI 在工作中干活
Glean: Putting AI to work, at work.
阅读英文原文 ↗
原文配图 Glean问题
企业知识绝大部分散落在非结构化数据孤岛里,不只是文档,还有代码、截图、邮件、演示、图表。知识工作者花在跨应用找答案上的时间比以往任何时候都多。生成式 AI 有望提效,但在安全利用企业专有数据的前提下规模化落地是重大技术挑战。
Glean 的解法
CEO Arvind Jain 及创始团队早年做 Google 搜索,特别适合解决企业生成式 AI 落地的最大难题之一:异构企业数据的无缝搜索。Glean 提供开箱即用的企业搜索加生成式 AI,具备企业级安全、基于角色的访问控制、可溯源引用,处理 PB 级实时变化的数据。部分客户接入多达 50 个应用:邮件、IM、日历、文档存储、工单、代码库、CRM、项目管理等。Glean 把强大的搜索与生成能力结合,给出带企业上下文、精确贴合查询的答案,并持续演进到检索、分析、摘要、内容生成和任务自动化。
原文配图 Source: Company Materials客户报告高参与度与高渗透率
参与度(使用频率)和渗透率(用例多样性)是衡量企业从软件中获得多少效用的两个指标。Glean 70–80% 的月活用户每周使用,仅略低于日历(80%)、邮件(95%)、浏览器(95%)等必备工具。这种高参与度横跨工程、销售、支持、BD、运营、IT、市场、财务等各类角色;最成熟的客户中超过 80% 的员工是月活用户。相比之下,其他 AI 方案往往只惠及一小部分员工,比如编码 AI 之于初级开发者、图像生成之于市场团队。
可量化的 ROI 与客户喜爱
客户以生产力提升、节省费用、员工满意度量化 ROI。一位 CIO 在裁员期间采购 Glean 以整合支出,说明在艰难时期 ROI 依然成立。客户调研 NPS 为 47%,高于 Slack 的 43% 和 Microsoft 产品的 33%;另一位 CIO 说如果撤掉 Glean 员工会造反。
前路
生成式 AI 仍在早期,Glean 有潜力成为把 AI 创新(搜索、聊天、Agent 等)带入企业的平台。下一代产品聚焦有效提示,推动用户形成以 AI 为中心的工作行为。
№ 07 2024-10-16 2,227 词
Palantir:创始人铸造厂
Palantir: The Founder Foundry
副题:拆解 Palantir 的创始人工厂:人才、使命与影响力的启示
合著:Cobi Blumenfeld-Gantz
阅读英文原文 ↗
背景
Palantir 校友创立了 Anduril(Brian Schimpf、Trae Stephens、Matt Grimm)、Affirm(Max Levchin、Nathan Gettings),执掌 OpenAI 研究(Bob McGrew)、Fox 技术(Melody Hildebrandt)等。Palantir 曾被误解为"窃取公民数据的间谍组织""服务公司""咨询铺子"。
原文配图 多年来外界给 Palantir 贴的各种标签如今随国防科技走红、市值近千亿并进入标普 500,风向已变;但这些是滞后指标,领先指标是 Palantir 营造的特殊环境和员工受到的训练。
原文配图 风向已转:市值与标普 500#1 不妥协的人才标准
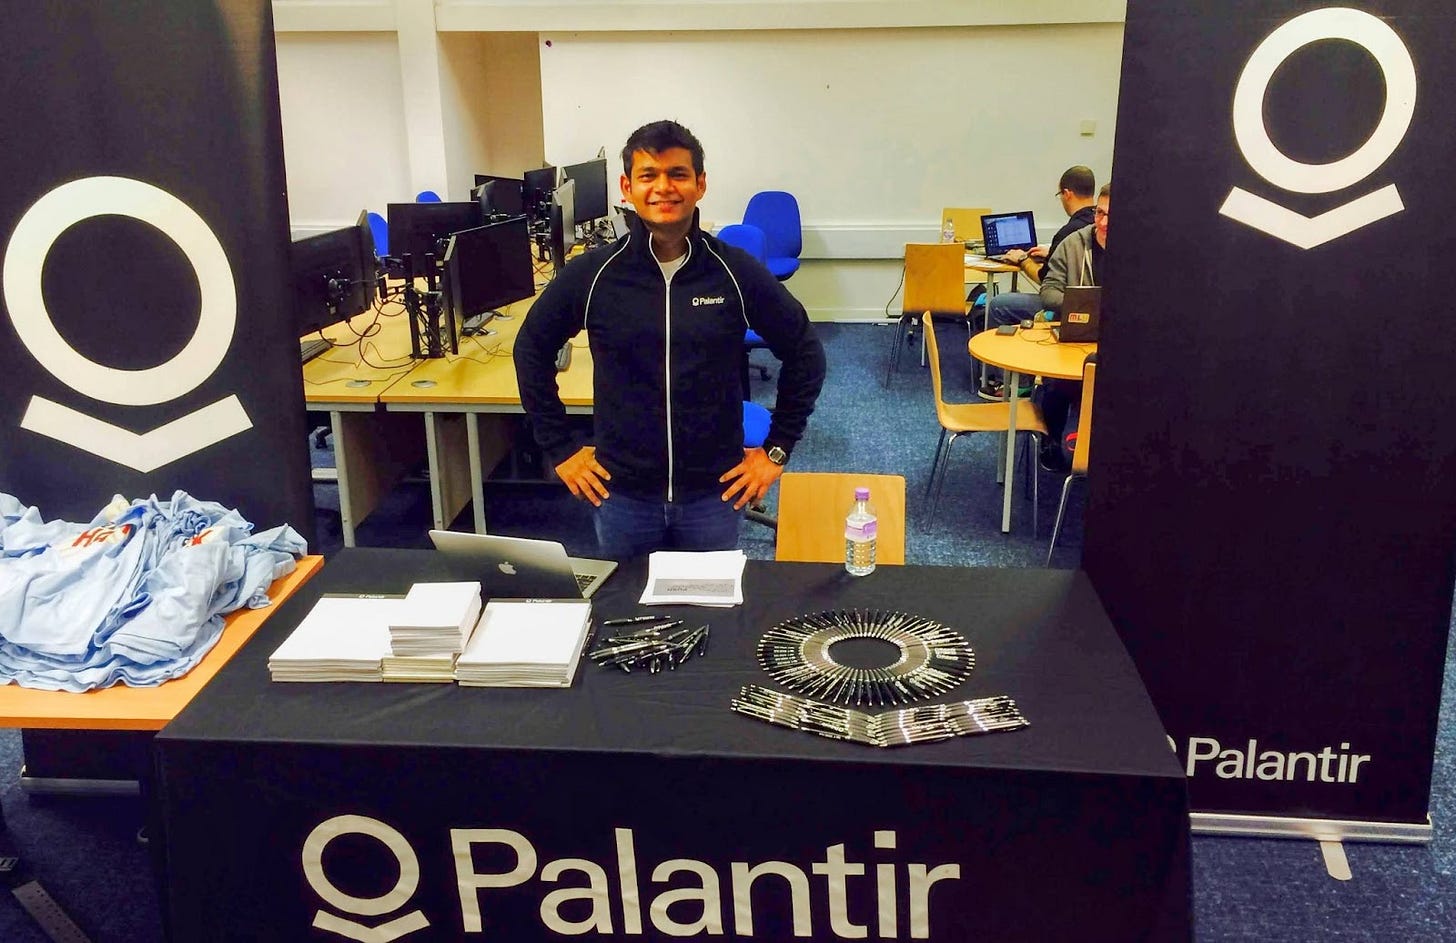
作者在职期间,每位候选人的终面都由创始人(通常是 Alex Karp 或 Stephen Cohen)亲自进行。这对组织是负担,但保住了极高标准。Palantir 筛选 T 型人才:某些领域很深,又能跨学科协作。CTO Shyam Sankar 的说法是:不要一群彬彬有礼的跨职能专业人士,要"X 战警,一群为善而联合的变种人"。面试官被要求自问"什么会让我们得出与现在相反的结论":表现好的候选人,下一轮要设计去寻找不录用的理由;表现挣扎但 T 型能力突出的,同样反问他们能展示什么让我们改变主意。
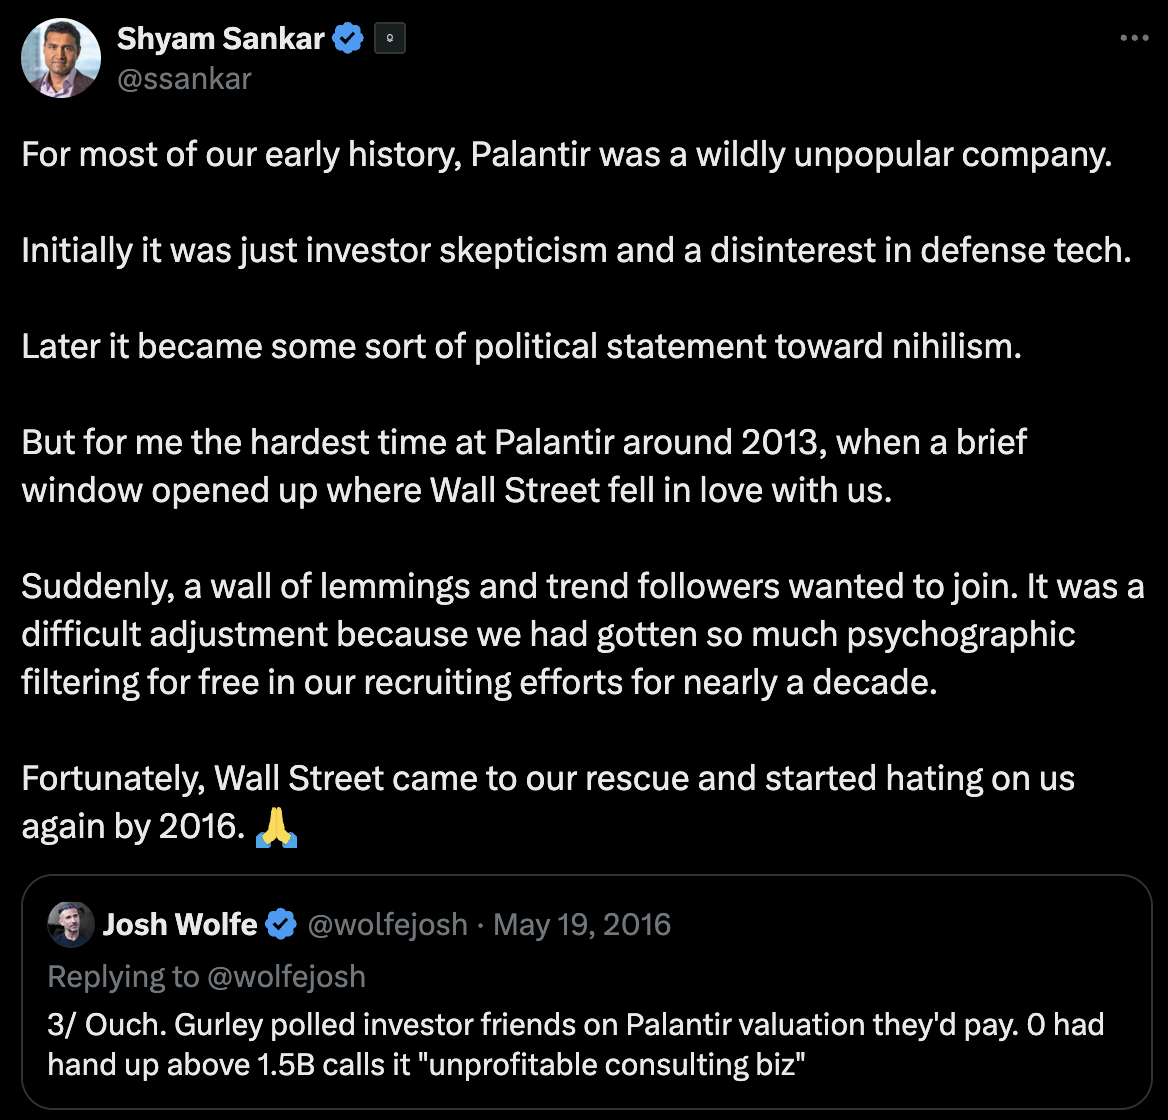
留住强者同样重要。商业负责人 Ted Mabrey 描述员工要熬过的阶段:产品多年更像白日梦、以性感独角兽身份融资、成为硅谷最被诟病的公司并有抗议者堵门、期权倒挂、上市、股价跌约 80%、再决定从头攀登一个新平台。Palantir 靠强烈的使命感把这群人留在了一起。
原文配图 Apoorv 在大学校园的 Palantir 招聘摊位#2 使命导向
入职头几周就明白"睡眠被高估,咖啡被低估"。每周 70 小时以上不是英雄主义,是常态(引 Shyam《反对工作生活平衡》)。员工受远超金钱的目标驱动,使命成为深植的个人承诺。每个项目结果被评为 WIN 或 LOSS(引 Shyam《赢的首要性》)。源自国防科技的使命思维被延伸到商业领域,商业团队也按军事编制:指挥官(CO)带 FDE(称 Delta)和非技术前线人员(称 Echo)。把使命设得比个人身份更大是制胜公式,类似的团队有 SpaceX(让人类多行星化)、OpenAI(造福人类的 AGI)、Anduril(为美国及盟友装备防务科技)。
#3 前线部署工程:交付结果而非软件
Palantir 开创了 FDE 这一新工种:嵌入客户现场解决落地问题,确保技术创造真实价值。FDE 不止交付软件,还搭建支撑生态,包括不光鲜的"管道工"活如数据集成,以及组织内激励对齐等非技术难题(比如实施导致某些岗位冗余怎么办)。成本高吗?是的,但 Palantir 的合同年金额中位数为 500 万美元,客户买的是结果,FDE 就是确保结果的人。
原文配图 Source: Meritech Comps(各公司合同年金额中位数)同样的需求出现在今天的 AI 领域,正如十年前的 Spark:既有技术栈不够成熟,新技术无法"直接就能用",FDE 让它们可行。FDE 已从被讥为"顾问"到被尊为前线"AI 工程师"。
#4 求真:解决真问题而非炫酷问题
核心原则是解决用户真实痛点,这需要"尝汤",到用户的环境里去,无论在街角还是地球另一端。案例一:部署在军舰上的服务器会因摇晃脱插,影响缓存频率、停机流程等一系列技术与流程问题,不在现场就不会知道。案例二:中东前沿基地每周要物理拔出每块硬盘盘点,需要设计不中断作业的关机与重装序列。很多工作是清洗数据、让数据更易用,不性感但最关键。
原文配图 Cobi 在军事基地训练美国海军陆战队#5 定义共同敌人
必读书是 Lawrence Wright 的《巨塔杀机》,强调理解对手。政府项目的敌人常是政府自身的低效官僚;商业项目的敌人有时是 BCG、McKinsey 等咨询巨头,有时是表格和信息孤岛的苦役。Palantir 甚至起诉美国陆军以突破采购壁垒并胜诉,与早年 SpaceX 的诉讼同一精神。案例:与 Booz Allen Hamilton 竞标一个民事机构大合同,问题不在于谁更好(Palantir 性能更优、价格更低),而在于"正义",政府会否选对的答案而非老路子。以"用花哨仪表盘糊弄基础数据问题的大承包商"为共同敌人,团队全力以赴。共同敌人也带来长期导向:打败 Raytheon、Booz Allen 或政府的技术无能,需要持久的工作。
原文配图 Cobi 在国土安全部一次国家特别安全事件的部署现场#6 扁平结构:直通领导层
Alex Karp 和 Shyam Sankar 常直接联系一线员工,穿透管理层级施加"伽马射线"。Shyam 写道:变种人要由变种人来指导,甚至提供最初的辐射剂量,否则再好的学府也会退化成"旅鼠学院";变异开始后,指导的最大特点反而是自主,极端成长不按计划来,导师要在密集期给予更多自主,并克制手把手的冲动。这与 Musk 和 Bezos 的风格类似,带来直接沟通、快速决策,也给公司里每个人学习的机会。
#7 彻底透明:从一切中学习
透明是建立全公司对齐的基础:几乎所有邮件全员可见;重要会议后写会议报告全员共享;出问题时做"五个为什么"复盘并存入内部 wiki;团队 wiki 和笔记开放给他人。这让教训迅速在团队间传播,形成集体学习的"蜂群思维"。
Palantir 的真正遗产
不是软件或合同,而是它训练并送向世界的人:带着对使命的执着、对结果的承诺、带队攻克宏大挑战的能力。对任何公司的启示:设定不妥协的人才标准、围绕共同使命凝聚、始终解决真问题。
№ 08 2024-12-14 865 词
为什么 Neuralink 是这十年最重要的公司
Why Neuralink is the most important company this decade
阅读英文原文 ↗
#1 现状
脑机接口(BMI)从 1924 年的脑电图到 2021 年猴子玩 Pong,2024 年 N1 已成功植入多位居家的人类受试者。它把运动皮层的神经信号转为数字指令,让四肢瘫痪者用意念移动光标、打字、发邮件、交流、从事艺术和音乐创作。首位受试者 Noland Arbaugh 用意念玩游戏、直播、操作笔记本;另一位受试者 Alex 用 CAD 设计复杂 3D 物体。Noland 的评价:帮他重新连接世界、朋友和家人,不再日夜依赖家人;最大的舒适是可以躺在床上使用,其他辅助技术都要坐起,坐姿会造成压疮和痉挛;"这应该给很多人带来希望"。
#2 工作原理
原文配图 N1 植入物N1 硬币大小,含微处理器、蓝牙、可充电电池,64 根超细线上分布 1,024 个电极。线极细极柔以减少植入损伤,细到人手无法插入,由专门设计的手术机器人精确植入。电极读取神经信号转为数字指令,经蓝牙传给外部设备;想着移动光标即触发运动皮层相应神经元。
#3 为什么是现在
原文配图 脑机接口带宽(BPS)的演进2024 年患者通过 N1 达到正常人约 50% 的带宽,明年有望达到人类水平,团队目标本十年末超越。智能分三层:边缘系统智能(快思考,安全与生存)、高阶推理(慢思考)、数字智能(手机、互联网、软件)。忘带手机像失去一条肢体,瓶颈在生物与技术之间的带宽。按已故 Krishna Shenoy 教授推广的比特每秒(BPS)计量:普通人无设备输出 1 BPS,打字或说话约 20,人类峰值约 40。脑机接口的进展:2017 年 2–4,2021 年 6.56,2024 年 N1 达到 9.5,2025 年目标 40,2030 年目标 100(编辑补充:Elon 预测 2030 年达到 1 Mbps 且超过 100 万人植入)。明年的提升靠两点:电极数从 1,024 增加到 3,000;电极利用率从约 10% 提到 40%。
#4 接下来
规模化:2025 年 27 台手术,2026 年 79 台。 视觉恢复:FDA 批准的 "Blindsight" 作用于视觉皮层,恢复基本光感和形状感知。 语言恢复:扩展到听觉皮层应用。 超越恢复:脑机接口可取代智能手机,成为人与 AI 的高带宽接口,为 1 亿以上用户增强认知、记忆和生产力。原文配图 从恢复到增强
№ 09 2025-05-22 2,058 词
为什么汽车比电脑先学会自动驾驶
Why Cars Drive Themselves Before Computers Do
副题:机器人汽车已就绪,机器人秘书还没……暂时。
阅读英文原文 ↗
引言
Waymo 已完成 1,000 万次无人驾驶载客(2025 年 5 月),Tesla 车主在 FSD 上累计约 36 亿英里,但没有一个 AI Agent 能在无人盯着的情况下订一张往返机票。开着 5,000 磅的车穿过车流似乎比在网页上点按钮难得多,为何数字自治反而落后?两者共享同一四层堆栈,Agent 卡在"行动"层的基础管道:汽车的行动只有油门、刹车、转向,道路规则少变;Agent 面对快速变化的数字环境、多几个数量级的自由度(点哪里、输什么、用什么工具),还要应付脆弱的 API、认证范围和数据隐私。作者预测秩序将翻转,原因有二:Agent 的数据飞轮更快、更便宜、更好(汽车出错的代价可能致命),并将在堆栈其他部分形成复利优势;MCP 这类标准协议大幅改善了行动层。
原文配图 预测:个人 AI 秘书达到 1 亿付费用户将早于 L4 自动驾驶第一部分:自治的主成分
原文配图 自治的四层堆栈:感知 → 推理 → 行动 → 数据飞轮Transformer 同时增强了物理和数字世界的推理层,但各系统在四层上的表现迥异。人形机器人被 ChatGPT 重新点燃热情,但作者怀疑它们更落后、更慢:缺乏大规模多样化的预训练数据,后训练的数据飞轮也慢而贵。
原文配图 不同自治系统在四层上的表现对比数据飞轮正成为关键变量,靠隐式和显式的人类反馈复利,如幼儿学走路,摔倒即反馈。OpenAI 有 5 亿周活用户,每天提供数十亿个反馈点,这是其产品迅速改进且讨喜的秘密。类比:X / Twitter 过度做定向让内容像"标题党",ChatGPT 过度做强化学习就变成"谄媚"。自动驾驶的反馈存在,但频率低、难整合、成本高。这个框架既解释了汽车为何暂时领先,也说明领先为何不会持久。
第二部分:数字自治深潜
软件 Agent 从"会回答的聊天机器人"跃升为"会做事的同事",受益于廉价丰富的反馈回路和 Web 上的即时分发,学习速度比硬件同类快几个数量级。它们看和想都很强,每次交互都在变聪明,但"做"还缺乏真实工作流要求的一致性、安全性和速度。补齐这最后一英里是最大的解锁。
原文配图 当前主流 Agent 类型在四个支柱上的基准三大趋势:
从单 Agent 到 Agent 群 :24 个月内经历三波:单轮问答机器人;单 Agent"副驾驶",可决定要跑的子步骤(GitHub Copilot 约 1,500 万用户,自动写 46% 的代码);多 Agent"小队",规划者、研究者、执行者、评估者分工。crewAI、AutoGen、LangGraph 让搭建变得简单,脆弱的提示链变成可复用的事件驱动微服务。行动层最脆弱,MCP 是重要改进 :Model Context Protocol 像连接推理与行动的 USB-C,标准化了 Agent 与外部工具和数据的对话。Host Agent 向轻量 Server 发请求,Server 负责认证、审计和 schema 版本,返回可供模型推理的响应,模型发出下一次调用时再循环。把"什么凭证、什么端点、如何重试"从提示词移进协议,让推理层放心规划、行动层安全而确定地执行。代价:以灵活性换成本,MCP 调用比 API 调用贵。身份体系有待成熟 :Agent 从只读升到写权限后,要继承企业认证的全部复杂性:SSO 会话、对象级 ACL、审计痕迹;一个过宽的 token 就可能泄露客户数据或删掉生产表。值得关注:Descope(拖拽式认证工作流,让 Agent 借用用户身份)、Arcade.dev(预认证的工具调用连接器,作用范围紧且可撤销)。第三部分:给建设者和投资者的启示
自治系统靠改进四层链条中最慢的一环取胜。Transformer 让推理对多数任务"够用",比赛转向可靠的输入管道、确定性执行、比同行更快的数据复利。
逐层审计找瓶颈 :炫酷 demo 常掩盖弱行动层(PC Agent)或受限飞轮(高精地图自动驾驶)。人形机器人的瓶颈是预训练数据(感知);客服 Agent 的瓶颈是低延迟下的指令遵循(感知与行动之间)。Waymo 的接管率曲线说明不同时期由堆栈不同部分驱动:2015–2020 年大幅下降(郊区路线的软件与传感器进步);2021 年飙升(测试转向旧金山密集城区,边缘场景更多);2022–2023 年回落(模型、策略、地图更新);2024 年回升(车队扩大 4 倍,测试里程偏向最难的未解场景)。原文配图 Waymo 接管率的演变加速飞轮 :从第一天捕捉显式和隐式反馈,自动化标注和再训练。例如 Glean 从用户活动中学习,既改进个性化又积累后训练数据;语音客服中记录哪些工具调用不准(路由、预订、取消),即使脱敏也是宝贵的后训练数据。嵌入自动评估 :搭建评估框架,包含确定性任务集,每次构建都跑(CI 式),失败则阻断部署并给出细粒度追踪。例如 Zapier 阻断未通过工具调用和任务成功检查的 PR;Airtable 把提示日志流入 Braintrust,标记失败,测试全绿才再训练。强化执行与安全 :结构化工具调用(MCP 为主流)、最小权限 token(引 Microsoft 研究员意外泄露 38TB 数据的教训)、可回放的审计日志;规模化前设定最低任务成功率。
№ 10 2025-06-08 269 词
音乐与技术创新的爱恨关系
Music and tech innovations have a love-hate relationship
副题:AI 会有所不同吗?
阅读英文原文 ↗
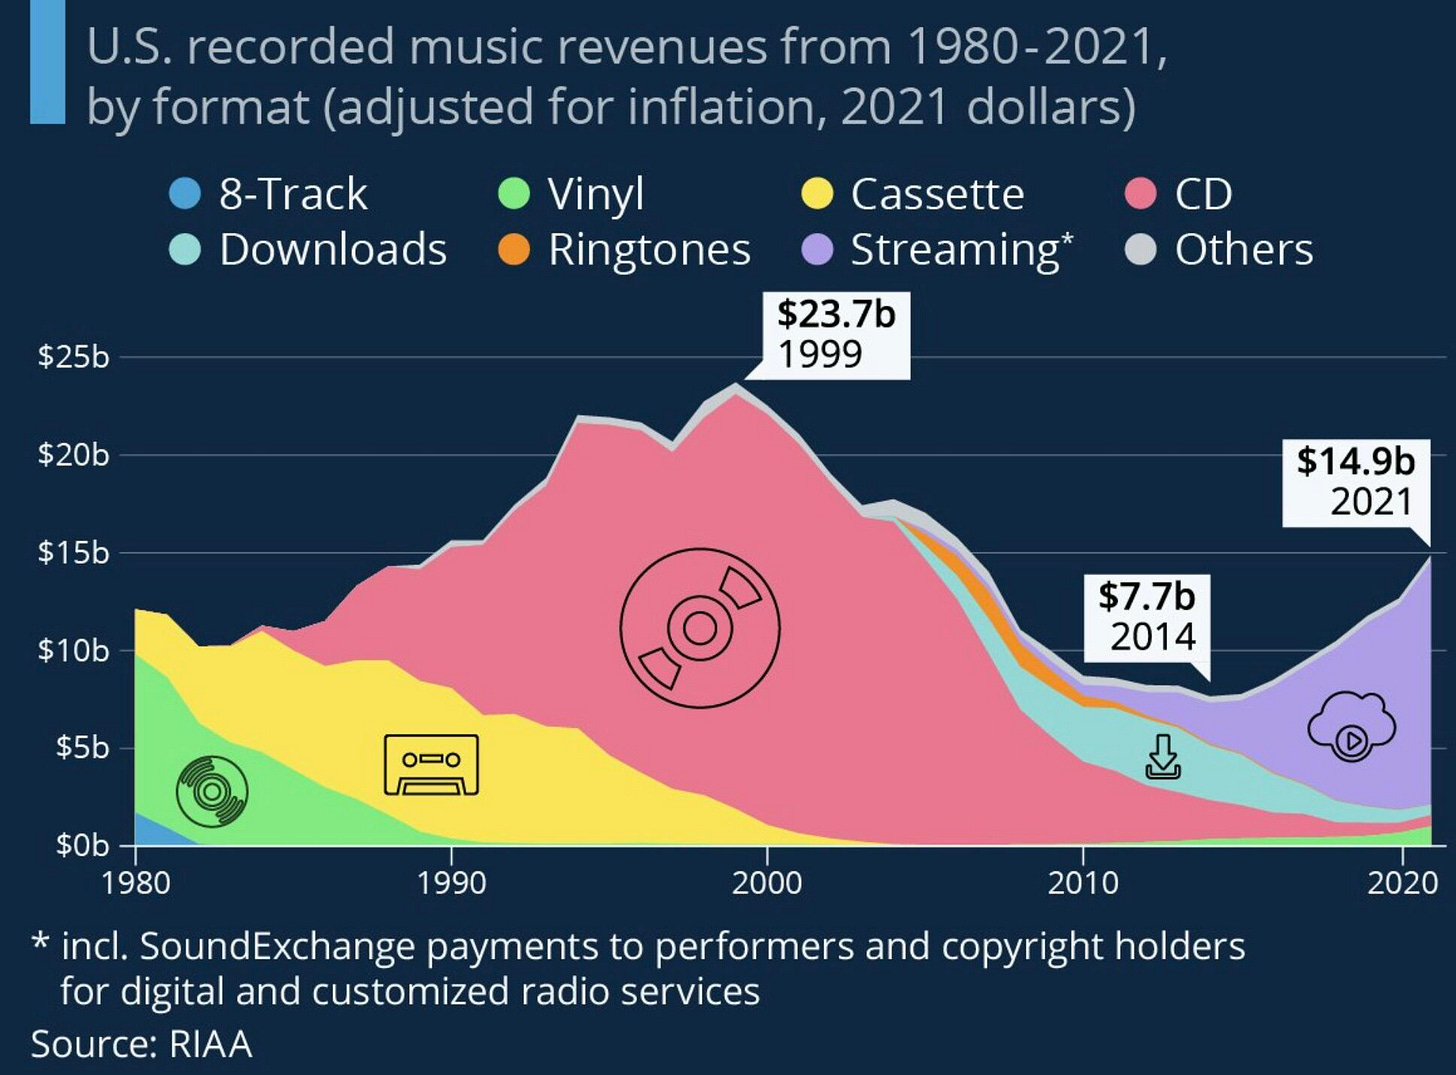
原文配图 美国音乐收入按载体的变迁每一次音乐技术创新都在吞噬音乐收入:CD 取代黑胶,下载挑战 CD,流媒体征服下载。剧本总是一样:新技术出现,威胁颠覆一切,官司满天飞,然后(也许)大家想出一起赚钱的办法。最典型的是互联网:CD 让音乐收入在 1990 年代末达到 200 亿美元以上的峰值,P2P 文件分享(Napster、uTorrent)让收入崩塌。十年后流媒体拯救了行业,有趣的是 Spotify 创始人 Daniel Ek 此前正是 uTorrent 的 CEO。如今 Spotify、Apple Music 把约 70% 的收入付给唱片公司(Universal、Sony、Warner),后者再付约 15% 给艺人;2021 年美国音乐收入重回 200 亿美元以上的历史高点。
这次不一样? Suno、Udio 等 AI 音乐生成器不只是分发音乐,而是创造音乐:在既有歌曲上训练,生成听起来专业制作的全新曲目。由此引出根本问题:AI 在 Taylor Swift 曲库上训练后写出热门歌曲,归谁所有?如何追踪哪些歌曲影响了一首 AI 生成曲?当 AI 音乐与人类作品无法区分时会怎样?唱片公司正与 AI 初创公司早期谈判,试图建立"AI 版 Content ID",让模型每次使用曲库都有版税回流,商讨指纹识别、归属和公平报酬。这些谈判将决定 AI 是音乐的下一个黄金时代,还是下一次大颠覆。
№ 11 2025-11-26 584 词
吞下痛苦,排出产品:FDE 行动手册
Eat Pain --> Excrete Product: The FDE Playbook
副题:与 OpenAI 前线部署工程负责人 Colin Jarvis 的对话
阅读英文原文 ↗
核心观点
当一项足够先进的技术能改造多个行业时,赢的供应商不是产品最好、模型最聪明或 demo 最炫的,而是能让技术在企业运营的混乱现实中真正起作用的。FDE 的概念很简单:让精通核心技术的工程师直接嵌入行业专家身边,紧密循环,深入理解领域,为特定场景构建可用方案,再提炼出可跨类似问题复用的通用部分。引 Palantir CTO Shyam Sankar:FDE "代谢痛苦,排出产品"。
OpenAI 的 FDE 原则(Colin Jarvis)
OpenAI 与 Palantir 一样在做规模惊人的 FDE,单个项目瞄准数千万到数亿美元、有时数十亿美元的客户价值。
从真正高风险的问题入手 :成功的公司不挑业务边缘的小场景。Morgan Stanley 把 GPT-4 部署到财富管理这一最大业务单元之一;一家半导体公司让 OpenAI 攻克其整个价值链中最大的浪费源。靠迭代建立信任,而非只靠技术卓越 :Morgan Stanley 的核心技术管道 6 到 8 周就跑通了,但花了 6 个月的试点、评估和迭代,财富顾问才信任到愿意用于客户。结果是 98% 的采用率,研究报告使用量增加 3 倍。评估驱动开发 :每段由 LLM 写的代码,没有一组验证其效果的评估就不算完成。这是信任的基础,也是 FDE 项目结束后移交给内部团队的基础。有意识地在确定性与概率性之间取舍 :LLM 用于它最擅长的细微和复杂之处,必须 100% 正确的地方用确定性护栏包裹。给考虑 FDE 的 CEO 的建议
Colin 最锋利的建议是对目的极度清晰:"你的 FDE 团队要达成什么?你是要把服务收入当作主要收入流,还是押注这些项目孵化出成功产品所带来的收入增长?这是截然不同的路线。"他反复看到的失败模式:想做产品公司,却因为服务收入短期更容易获得而被拖向服务,"突然就失去了战略视角"。需要的纪律是在艰难时刻说不,哪怕对方为非战略性的工作出大价钱。
北极星:你必须带着产品离开。 FDE 是从 0 到 1 的动作。第一个项目可能只有 20% 可复用,再做两三次到 50%,然后推进到业务的规模化部分。OpenAI 的 Agent SDK 和 Agent Kit 正是这样来的:起于 Klarna 的定制工作,在 T-Mobile 扩展,然后产品化给所有人。如果不是朝着可复用的东西构建,你只是在"多绕几步的咨询"。
№ 12 2025-12-18 1,229 词
Revolut 的故事:十年复利
The Revolut Story: A Decade of Compounding
副题:……后面还有很多个十年
阅读英文原文 ↗
BLUF · 一句话概要 作者研究 Revolut 多年并于 2025 年初投资。Revolut 以"把银行当作全球软件产品来做"的论点突围,靠速度、全栈自有、真实的地理扩张、8 条以上收入流和"下注式"的内部风投文化,十年后仍像刚刚开始。
起点
2010 年代中期,智能手机普及、2008 年后对传统银行的信任动摇,新银行(neobank)浪潮兴起。论点简单优雅:传统银行 App 糟糕、隐性收费、官僚节奏,移动优先的挑战者能做得更好。2015 年前后欧洲几乎同时鸣枪:N26 在柏林,Monzo 和 Starling 在伦敦,Chime 在旧金山,TransferWise(现 Wise)做跨境汇款。各有切入点,但多数押注一次赢一个市场或一个品类。
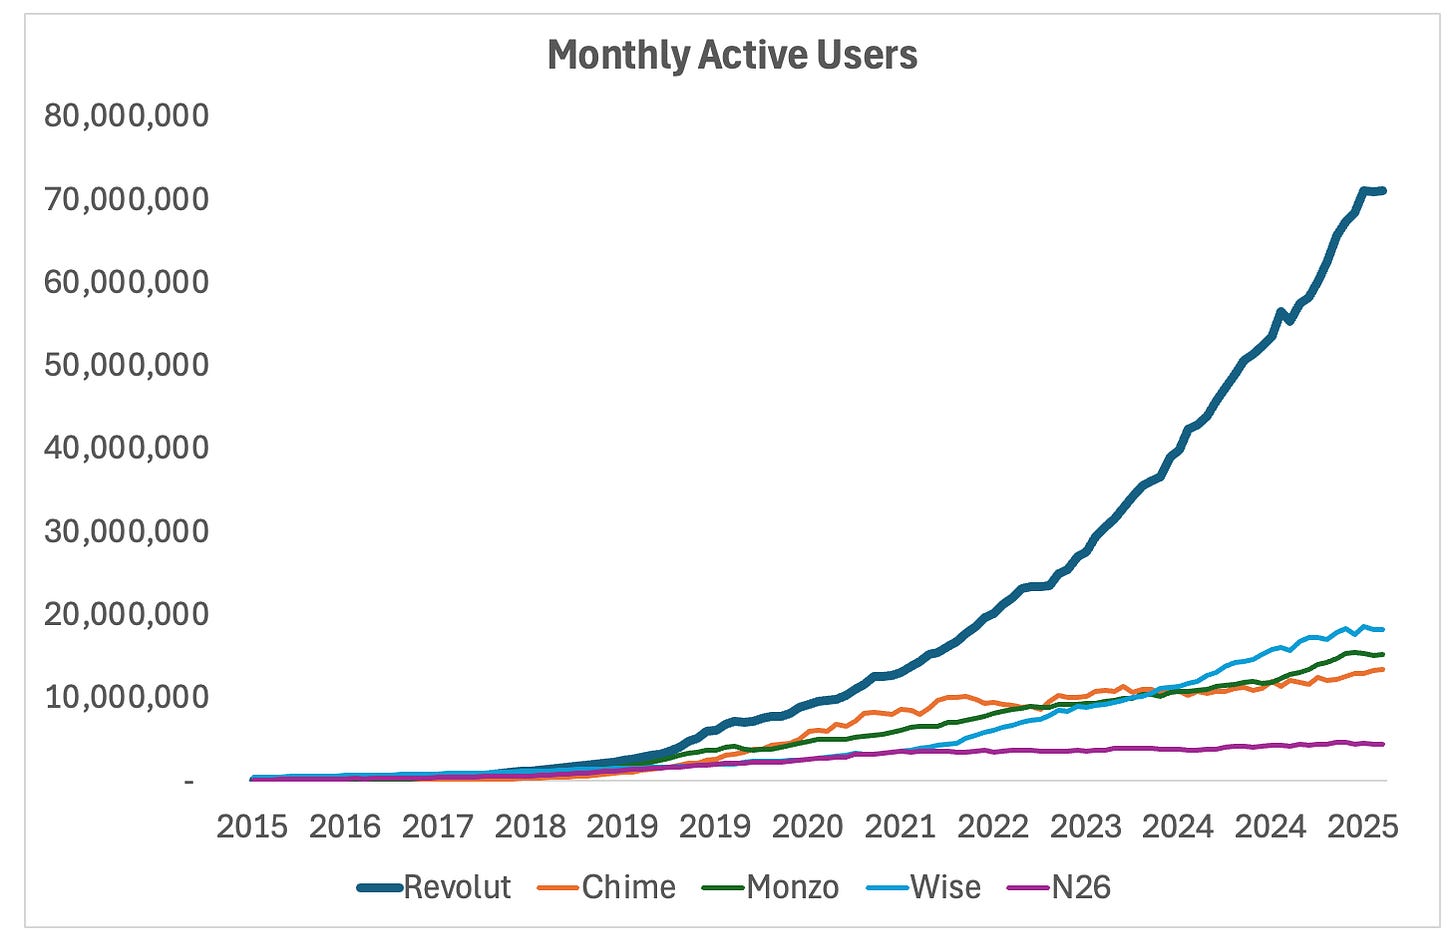
Revolut 2015 年 7 月入场,论点完全不同:把银行当作一个全球软件产品来做,从第一天起全栈、无国界。 Nikolay Storonsky(前 Lehman、Credit Suisse)和 Vlad Yatsenko 以面向旅行者的预付卡加 App 起步,多币种持有、银行间汇率,相比银行悄悄抽 2–3% 外汇费是激进的便利。如今 Revolut 全球 6,500 万客户,远远甩开同行。
原文配图 Source: SensorTower (mobile users only)为何突围
典型的 fintech 建议是一次赢一个市场或一个品类,Revolut 从早期就同时做两件事:每年加新产品,同时进入新国家。大胆且有争议,但奏效。
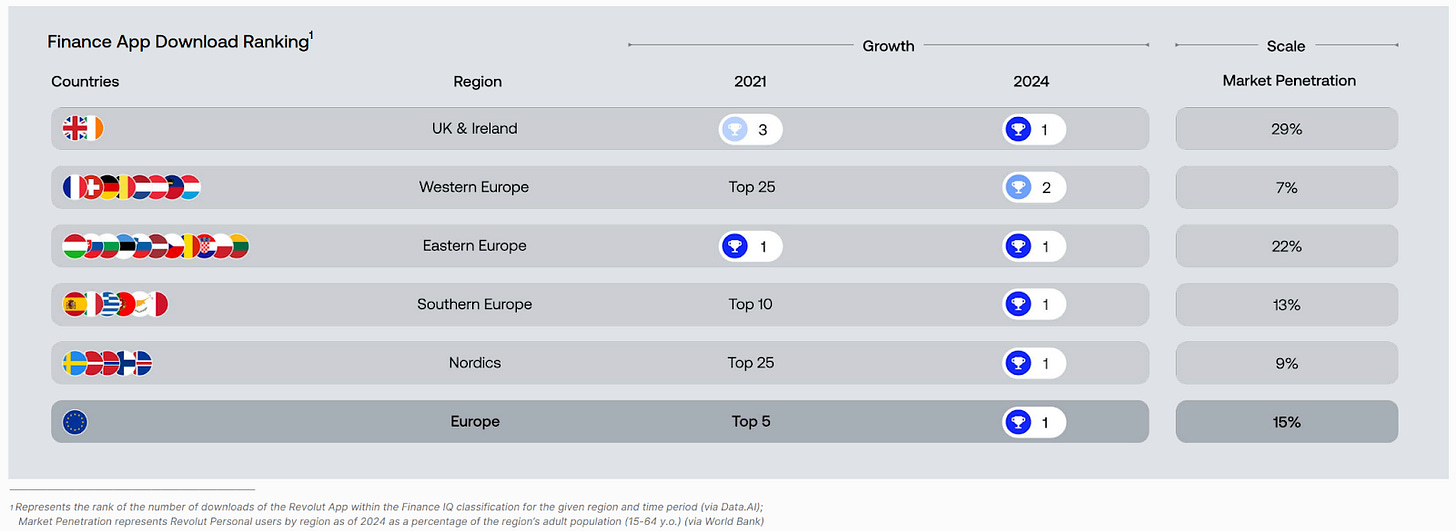
速度即战略 :团队以闪电执行和不停发布著称。Storonsky 的观点是发布越快、迭代越多,赢的机会越多。几年内推出加密交易(2017)、股票交易、储蓄金库、预算工具、保险、P2P 支付、企业账户等,成为金融超级 App,而竞品坚守更窄的剧本。全栈自有 :竞品依赖 BaaS 合作方或中间件,Revolut 痴迷投资自有基础设施,如今持有数十个监管牌照。控制技术栈就能控制用户体验、更快发布,并且无需与合作方重新谈判就进入新市场。地理野心配地理能力 :很多 fintech"宣布"国际化,Revolut 真正赢下市场。Monzo 美国扩张停滞,N26 脱欧后退出英国,Chime 只做美国;Revolut 在 48 个国家运营,在十多个欧盟国家是下载量第一的金融 App。原文配图 Source: Revolut 2024 Annual Report收入多元化带来业务韧性
多数 fintech 严重依赖单一模式:Nubank 约 85% 来自放贷,Chime 约 70% 交换费,Stripe 90% 以上支付,Ramp 约 90% 交换费。主收入流遇到监管上限、利率变化或竞争压力时,整个业务都会感受到。Revolut 有 8 条以上收入流:卡支付与交换费;订阅(Plus、Premium、Metal、Ultra);外汇与跨境转账;财富产品(股票、加密、商品、货币基金);信贷(个人贷款、信用卡);企业账户与 B2B;商户收单(Revolut Pay);存款净息差。没有单一产品超过约 30%。加密交易量崩溃时订阅继续增长;交换费被监管压缩时信贷放量;利率下行时支付和外汇补上。且很多收入流是纯软件毛利(订阅、交易费、汇差),每个新客户以极低边际成本增加收入,配合成本纪律,规模化后净利率 25% 以上。
原文配图 Source: Internal Analysis以下注思维经营
公司像内部风投组合运作:任何时刻有几十个核心业务之外的赌注在跑,只有一部分能毕业成真正的业务线,还有几十个尚未开始试点。传统银行由委员会审批三年产品路线图;Revolut 做实验、无情度量、砍掉不行的、加码可行的。8 条收入流不是战略规划的产物:加密(2017 年)、企业账户、信贷都始于一个赌注。这与风投组合逻辑相同:接受多数实验失败,但确保跑了足够多的实验,让赢家足以补偿。
当前组合的期权价值:
信贷 :尚在早期但增长快,已在 9 个国家上线,房贷在路线图上。高毛利高风险,若执行得当且不爆雷,将进一步改变单位经济。企业银行已跑通 :在消费者平台之上建起可观的 B2B 业务。地理扩张继续 :正在申请巴西、印度、墨西哥、哥伦比亚和亚太的牌照。"成熟"的欧洲市场 4,000 万以上用户对应约 5.6 亿人口,扩张市场是数十亿人。目标是 2040 年覆盖 100 个国家,成为真正的全球数字银行。十年过去,复利才刚刚开始。
原文配图 视频:Revolut, Europe's $20Bn Neo-Banking Giant(原文嵌入)
№ 13 2026-01-13 916 词
2026 年预测
2026 Predictions!
阅读英文原文 ↗
八条预测
流动性之年 :AI 与科技 IPO 和直接上市新增 1 万亿美元以上的公开市值,私转公的堰塞湖打通。候选:SpaceX、Anthropic、OpenAI、Databricks。Google 收复失地 :去年就说"别忘了 Google"。2026 年 Gemini 是不是最好的模型不重要,它靠聪明的交易(Apple、Reliance Jio)加分发(Gmail、Maps、Search)取胜。20 亿用户不选模型,他们用默认。AI 大分拣 :用户主动比较,ChatGPT 干 X、Claude 干 Y、Gemini 干 Z,凭感觉和体验选偏好。记忆复利,切换成本上升,年底格局比年初更碎片化。AI 学会先开口 :不再是等在盒子里的聊天机器人,而是环境化、情境化,主动注意、提醒、问候。关系反转。开源继续攀升 :Agent 学会混搭,前沿模型干重活,微调的开源模型干其他一切。混合栈成为默认,收银机在模型服务平台响起。Meta 之问 :2025 年 Q1 的 Llama 4 之后无重大进展,关键人才离职,没有长期研究赌注。2026 年该交卷了。门槛抬高 :今年训练花 50–250 亿美元的实验室,需在未来 12–24 个月拿出同等规模的毛利。研发回报期成为上市前的核心指标。消费级 AI 遭遇成长烦恼 :40 多个国家大选,含美国中期选举。AI 努力保持中立,"AI 左右选举"的叙事仍会成形。8b. 消费级 AI 的轻松增长期结束 :80 亿人中已有 10 亿用 AI,较去年增 3 倍。再翻三倍意味着成为全球第一的消费应用;参考 Facebook、WhatsApp、YouTube 大约在 30 亿用户量级。
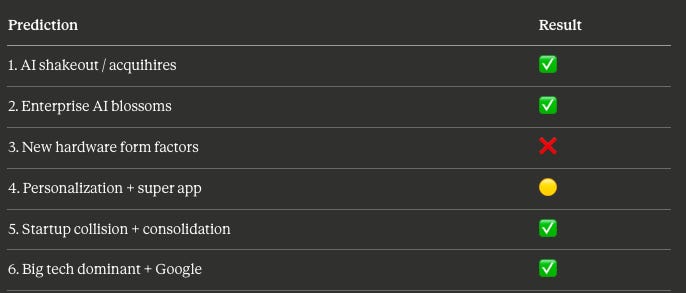
2025 年预测对账(6 条:4 中、1 半、1 错)
原文配图 2025 年预测计分卡AI 洗牌加剧,前沿实验室整合或人才收购 :✅ 大厂通过"授权加人才收购"结构投入 400 亿美元以上:Microsoft 与 Inflection(6.5 亿)、Amazon 与 Adept(3.3 亿)、Google 与 Character.AI(27 亿)、Google 与 Windsurf(24 亿)、Meta 与 Scale AI(143 亿)、Nvidia 与 Groq(200 亿)。套路:授权 IP、雇走团队、留下空壳。企业 AI 开花,软件工程组织转型,算力与薪资的权衡成真 :✅ 软件工程、客服、法律、医疗在 2025 年采用增长 10 倍。新硬件形态以 AI 为杀手应用 :❌ Ray-Ban Meta 眼镜表现平平,AI 杀手应用在手机和浏览器里,不在新硬件上。个性化提升 10 倍,使用集中到超级 App :🟡 记忆功能都上了(ChatGPT、Claude、Gemini),上下文窗口达到 1,000 万 token 以上,但超级 App 没有出现。ChatGPT 达到 8 亿以上周活,但没有替代你的手机应用。暂时。初创公司与前沿模型相撞,整合加速 :✅ 前沿模型吃掉"AI 套壳"的地盘,价值链压缩为模型提供商或深度垂直应用;AI 人才收购总额 400 亿以上;零利率时代的初创公司面临折价轮或关闭。IPO 大坝守住了,但 2026 年会决堤。大厂保持主导,别忘了 Google :✅ 超大规模云厂商投入 2,000 亿美元以上建 AI 基础设施并吸纳最好的人才。Google 复苏:Gemini 改进,深度集成 Gmail、Maps、Search,与 Apple 和 Reliance Jio 达成战略交易。分发加交易加更好的模型等于势能。
№ 14 2026-01-15 1,034 词
祝贺 Parloa!
Congrats Parloa!
副题:D 轮
阅读英文原文 ↗
BLUF · 一句话概要 Altimeter 三轮加持的客服 AI 公司 Parloa 完成 General Catalyst 领投的 3.5 亿美元 D 轮,估值 30 亿美元;它专为财富 200 强联络中心而建,以 FDE 模式部署,在欧洲最复杂的市场验证后正进军北美。
背景
Altimeter 追问:能改造行业的杀手级 AI 应用在哪?客户体验是最大也最重要的领域之一。Altimeter 2024 年 2 月领投 Parloa B 轮,2025 年 3 月联合领投 C 轮。
问题
呼叫中心坐席的工作极其残酷:63% 报告高度倦怠,年流失率约 35%,是其他职业的两倍多;雇主每人流失成本 1 万到 2.1 万美元,形成恶性循环。这不只是劳动力问题,也是客户体验问题:倦怠的坐席无法提供有同理心的服务,而客户期待跨渠道的个性化即时帮助。AI 提供根本性的重构:AI 坐席不会在第 50 通难缠电话后失去耐心,第一次和第一万次同样稳定。这不是消灭人,而是把 AI 部署在它擅长之处,把人解放给高价值对话。全球联络中心年支出 5,000 亿美元,领先企业正围绕 AI 重建客户交互栈。
为大型企业设计
Parloa 不做 SMB,专为财富 200 强复杂联络中心、数百万客户交互而建。企业联络中心需要集成传统电话系统(Genesys、Avaya、Amazon Connect)、CRM、支付网关和数十个后端系统,横跨多地域多语言。这不是自助模式:Parloa 部署 FDE 嵌入客户团队实施和运营。把关键任务 AI 部署进复杂环境,需要工程师在前线。一旦嵌入财富 200 强的联络中心,切换成本巨大。
为全球复杂性而建
欧洲是全球最苛刻的市场:24 种欧盟官方语言、严格监管、艰难的劳动力经济(英语离岸坐席每小时 5–6 美元,德语坐席 15–17 美元,约 3 倍)。泛欧企业要服务德国、法国、意大利和北欧客户,是人员配置的噩梦。AI 改变了这个方程:Parloa 的 AI Agent 管理平台是生成式 AI 原生的,不是老系统外挂 LLM。AI 坐席说 100 多种语言,人工接手时也有实时翻译;一个坐席同时处理德语、法语、荷兰语、瑞典语,无需分团队。平台支持自然语言简报、企业集成和部署前的大规模仿真测试。能赢下欧洲的监管、语言和劳动力复杂性,就能赢下任何地方。客户包括 Booking.com、Allianz、Swiss Life、HealthEquity 等多家财富 200 强:Swiss Life 路由速度快 60%、准确率 96%;柏林勃兰登堡机场的多语言语音坐席 CSAT 达 85%。这些是处理数百万对话的生产部署,不是试点。
前路
在欧洲验证后,Parloa 正大举进军企业软件最大的市场北美。Chris Silver 从 Five9 加入任 CRO,Latané Conant 从 6sense 加入任 CMO(曾助其从 75 人扩到 1,200 人以上),加上 CPO Csaba Tamas(前 AWS)。办公室在柏林、慕尼黑和曼哈顿,ARR 超过 5,000 万美元,自 B 轮以来收入翻两番。客服是滩头,愿景覆盖整个客户体验:每个触点都会话化,不只是支持电话,还有 App、网站和主动外联。AI 坐席主动发现问题、引导上手、发现追加销售机会,把联络中心从成本中心变成增长引擎。这是创始人 Malte 和 Stefan 一直追求的愿景。
№ 15 2026-01-23 1,069 词
我们为什么投资 Baseten
Why we invested in Baseten
副题:构建推理抽象层
阅读英文原文 ↗
原文配图 Source: Baseten(收入增长)推理是复利而非线性
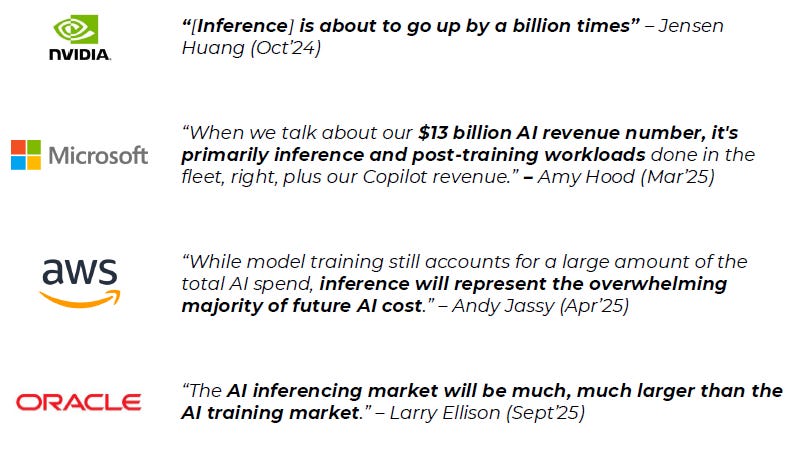
Jensen Huang 在 BG2 播客上说"推理即将增长十亿倍",这一观点正在业内获得认同。AI 从 demo 变成默认后,瓶颈从训练转向生产推理。早期 AI 产品是单请求单响应,下一代是循环:检索、推理、调工具、重排、合成,且一次用户交互往往重复多次。每个任务的推理事件成倍增加,对延迟、可靠性和成本的要求抬高。同时 AI 栈越来越"常开":核心工作流依赖模型调用时,宕机和抖动不可接受,团队需要一个满足生产预期的平台,自己专注差异化产品。数据佐证:Google 2024 年 4 月处理 9.7 万亿 token,2025 年 4 月 480 万亿(12 个月增 50 倍),2025 年 10 月超过 1.3 千万亿每月(3 个月又增 3 倍)。
原文配图 Google 每月处理的 token 量开放权重扩大了版图
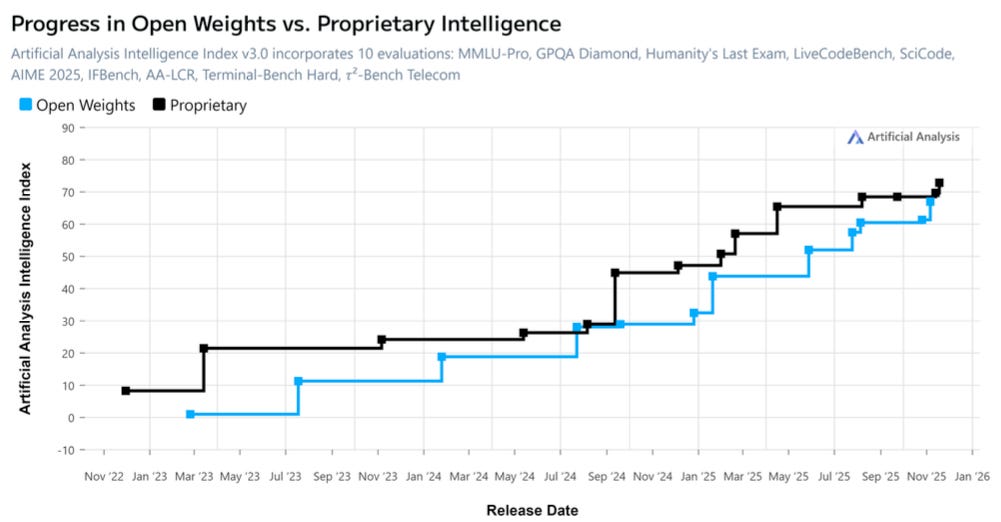
开源模型快速进步,更多团队运行模型组合:前沿 API 做特定任务,开源模型跑大流量负载,微调模型做领域任务。世界走向多模型未来而非单一模型。但把开源模型跑好需要运行时、量化、编译、缓存、硬件选型、容量管理等专业能力,多数应用团队不想为了发产品而建一个内部"GPU 平台团队"。
原文配图 Source: Artificial Analysis (Dec 2025)Baseten 的核心价值:抽象
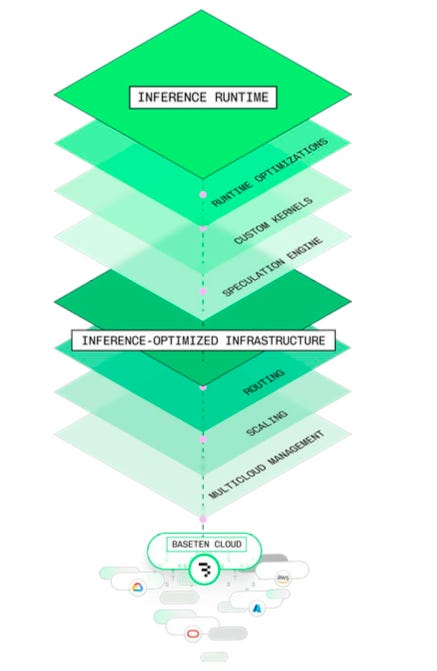
Baseten 之于推理如 Stripe 之于支付:把运维和工程负担抽象掉,让产品团队更快。也类似 Snowflake 和 Databricks:云厂商提供原始基础设施,赢家把它变得易用、易扩、可预期。云厂商可能自己做更多?作者承认这一现实,但押注专注的平台能提供最佳的性能与总拥有成本组合。Baseten 的切入点不只是"GPU as API",而是接近生产系统的推理栈和工作流:
性能工程:跨运行时和服务技术的系统优化,改善真实负载的延迟和吞吐。 多云容量管理:跨环境采购和管理容量,为区域或供应商故障设计韧性。 部署灵活性:专用部署、混合部署,满足严格的安全要求。 开发者体验:干净的接口,让团队发布、调试、迭代而不把基础设施变成全职工作。 深度客户伙伴关系:"对结果负责"的姿态。联合创始人 Tuhin Srivastava 和 Amir 围绕客户共创构建公司,并以 Joey Zwicker 领导的 FDE 模式制度化,工程师嵌入客户并对生产结果负责。原文配图 Source: Baseten Baseten 是 AI Agent 的指数
如同 Stripe 是互联网经济的指数,Baseten 是 AI 经济的指数:随应用层的成功而扩张,应用增长推理量就增长,获得的是 AI 原生用量复利的敞口,而非席位扩张。公开客户包括 Cursor、Notion、OpenEvidence、Abridge、Clay、World Labs、Gamma、Writer、Bland AI、Descript、Ambience、Hex、Wispr Flow、Latent Health 等增长最快的公司。Baseten 2025 年收入增长 10 倍。
客户案例:OpenEvidence
OpenEvidence 服务临床医生,需要在诊疗点提供快速可信的信息。规模化后,自建推理耗费越来越多时间和注意力,分散了产品焦点;迁到 Baseten 后卸下基础设施工作并改善性能,团队专注为医生构建工具。这是常见故事:从自建或通用云组件起步,生产要求变硬后撞墙,Baseten 就是让团队扩展推理而不必变成基础设施公司的那个点。
论点
推理正成为 AI 的主导工作负载;开放权重和多模型架构扩大了部署范围;Baseten 在构建让生产推理易采用、高效运行、大规模可靠的抽象层,有望成为 AI 应用经济的基础平台。
№ 16 2026-03-02 1,592 词
消费级 AI 现状(一):使用量
The State of Consumer AI. Part 1: Usage
阅读英文原文 ↗
BLUF · 一句话概要 作者公开承认两年前"Google 和 Meta 会赢"的判断错了。AI 应用周活突破 10 亿,ChatGPT 独占约 70%,且是在没有既有分发平台的情况下从零建立的,是唯一同时拥有存量和流量、走向"核心工具"的 AI 应用。
开篇认错
两年前作者论证分发胜过模型质量、Google 和 Meta 最有可能赢,当时 ChatGPT 约 1 亿周活。"那场辩论已有结果。我错了。"如今 AI 应用周活突破 10 亿,ChatGPT 独占 9 亿。本文论证 ChatGPT 是唯一同时拥有安装基数和新用户势能、可成为 WhatsApp 和 Chrome 级核心工具的 AI 应用;其他挑战者浪潮都退去了,ChatGPT 持续复利。
方法论说明:数据来自 Sensortower,仅移动端,可能低估偏 Web 的 AI 使用。作者用周活作为 DAU 与 MAU 之间的折中,便于把新兴 AI 产品与成熟消费应用比较。
1. 两匹马的赛跑,ChatGPT 拉开
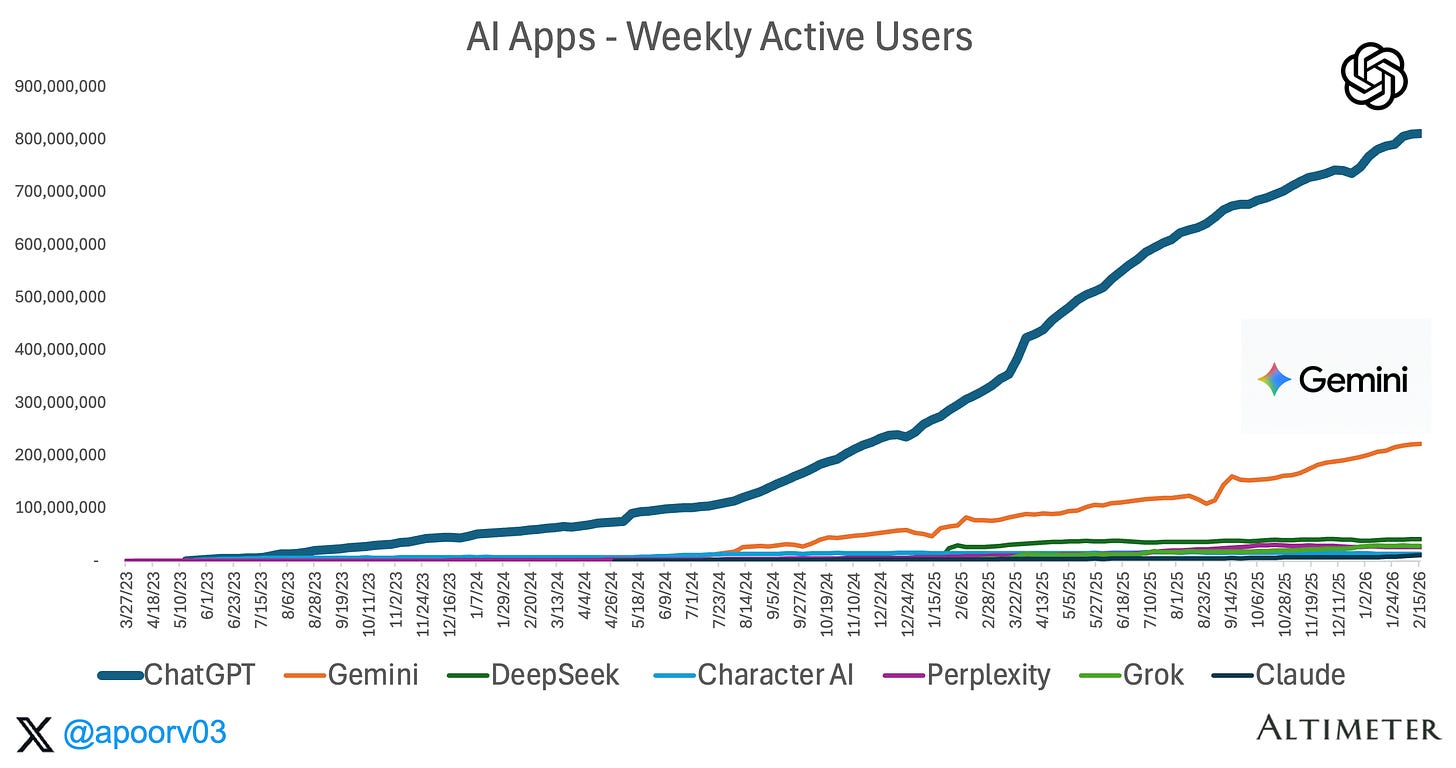
原文配图 AI 应用周活用户数(Source: Sensortower)AI 应用总周活从 2024 年 1 月约 1 亿到 2026 年 2 月超过 12 亿,两年约 20 倍,史上没有哪个品类扩张如此之快。ChatGPT 9 亿周活大于 Spotify(约 6 亿),与 TikTok(约 15 亿)、Instagram(约 13 亿)同一区间,逼近作者视为必备工具的 WhatsApp 和 Chrome(各约 25 亿)。写原文时 ChatGPT 在消费巨头旁边只是个零头,如今在同一联赛。
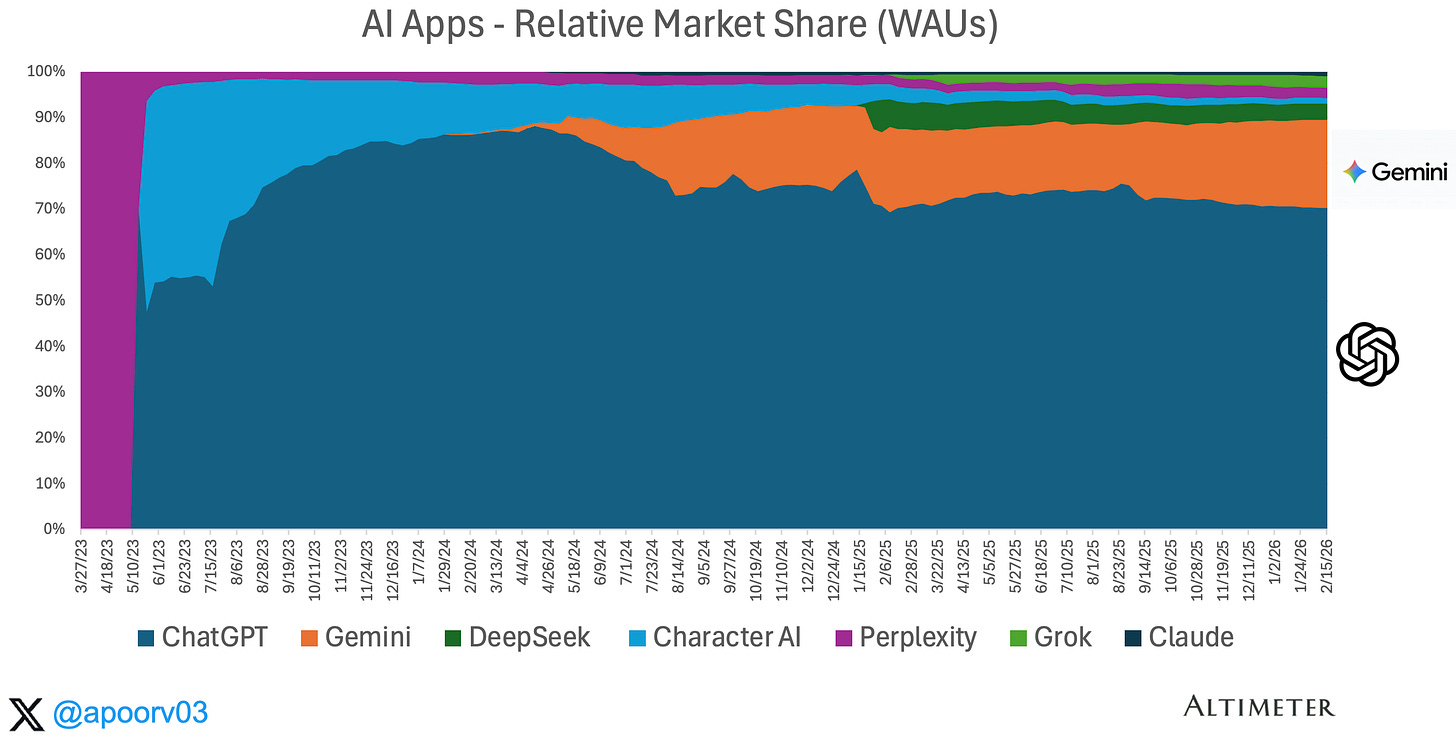
原文配图 AI 应用周活份额(Source: Sensortower)ChatGPT 稳定占 AI 总周活约 70%,Gemini 15–20%,其余(DeepSeek、Grok、Perplexity、Claude、Character AI)合计约 10%。品类增长 20 倍,几乎全部归于两个应用:ChatGPT 从零起步,Gemini 靠 Google 40 亿用户的分发。
2. ChatGPT 与消费巨头:比你想的更近
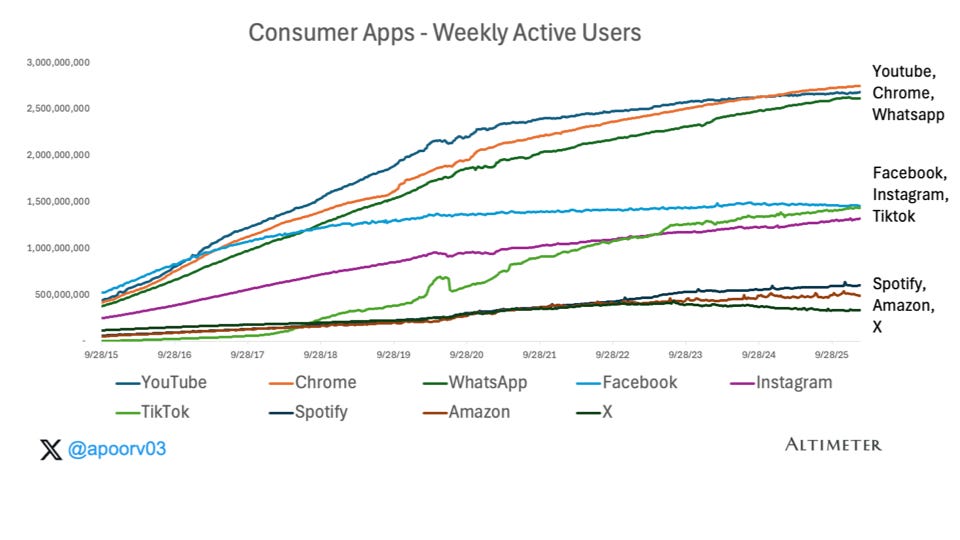
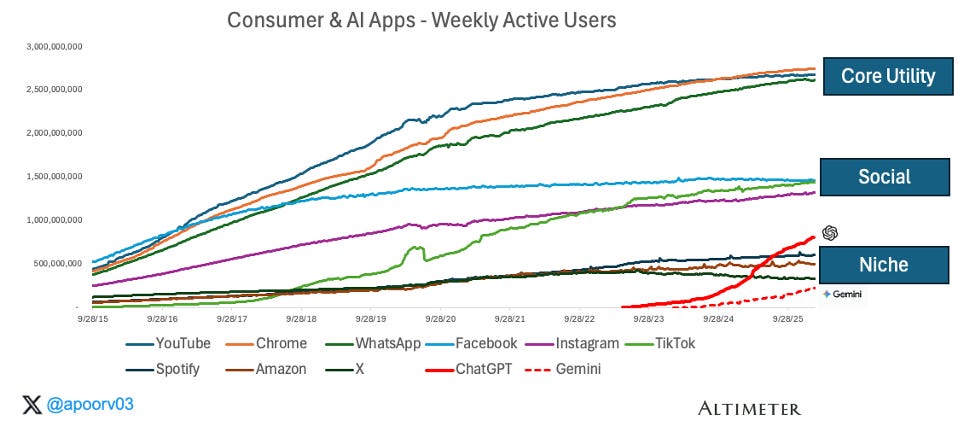
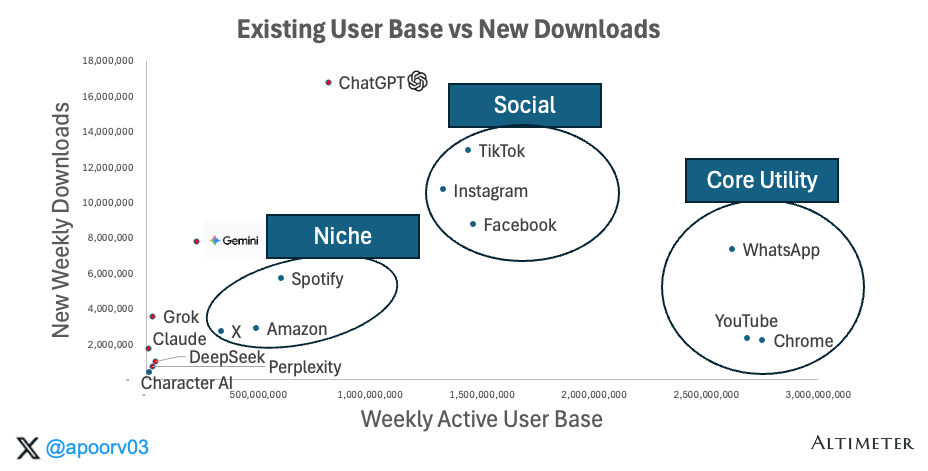
原文配图 消费应用的三个层级(Source: Sensortower)过去十年消费应用已分成三层:
核心工具 (20–30 亿周活):YouTube、Chrome、WhatsApp。它们是基础设施,深嵌日常生活,更像操作系统功能而非独立产品;增长缓慢稳定,靠智能手机渗透而非病毒循环。社交平台 (10–15 亿周活):Facebook、Instagram、TikTok。靠内容图谱和社交强化形成习惯,用了多年爬到这一层,增长已基本见顶。细分应用 (3–6 亿周活):Spotify、Amazon、X。品类领导者,用户基数巨大但需求更具体。AI 已不只是与自身对标的品类,它属于与史上最大消费产品同一张图。
原文配图 AI 应用与最大的消费产品同图对比ChatGPT 8–9 亿周活已越过细分层,正迈向社交层,用时约三年,而 Instagram 用了五年、TikTok 四年。Gemini 约 2 亿周活,正从下方进入细分层。
3. 一年四季:OpenAI、Google、xAI、中国
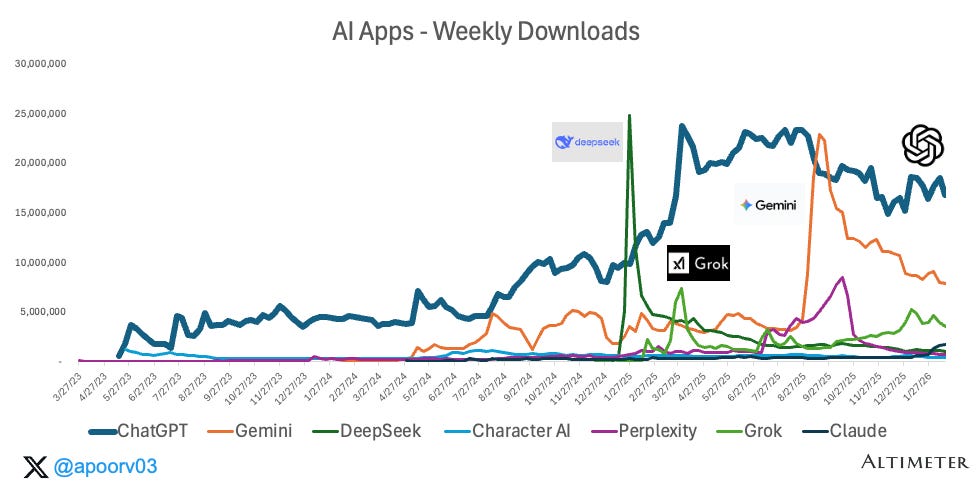
原文配图 AI 应用每周下载量(Source: Sensortower)周活图讲的是集中,下载图讲的是混乱。过去一年每个季节都有一个挑战者被推到聚光灯下:
2025 年冬:中国 。DeepSeek 1 月周下载突破 2,500 万,短暂比肩 ChatGPT,开源模型的性能让行业措手不及,引发"OpenAI 有麻烦了"的评论。几周内下载回落到峰值的零头。2025 年春:xAI 。Grok 靠 Elon Musk 在 X 上的分发和一连串模型更新冲高,下载飙升、媒体跟进,但持续使用没有以同等规模出现。2025 年夏:Google 。Gemini 的高光时刻,周下载超过 2,000 万,几乎全靠 Google I/O 前后爆红的 nano banana 图像生成模型。这是"模型时刻"而非持续的行为转变,所以随后回落。Google 的分发放大了触达,但催化剂是一个真正好的图像模型带来的病毒式分享。每个季节:OpenAI 。ChatGPT 持续复利,下载量始终居首或接近,没有波动。"图上那条平稳的线才是重要的。"荣誉提名:Anthropic 。写作时 Claude 登上 App Store 免费榜第一,是又一个季节性尖峰还是更持久,值得观察。规律很清楚:每个季度都有新的"ChatGPT 威胁"叙事,每个都消退。下载因炒作而尖峰,使用归于赢得日常习惯的应用。
4. AI 应用中只有 ChatGPT 像一个可能的新工具
原文配图 存量 vs 流量散点图(Source: Sensortower)作者用存量(现有用户基数)和流量(新下载)看势能。散点图上 ChatGPT 所处的位置,只有核心工具(WhatsApp、YouTube、Chrome)和主导社交(TikTok、Instagram、Facebook)共享:庞大的现有基数加高新增下载。Gemini 下载可观,但尚未转化为可比的安装基数;其余 AI 应用聚在左下角,基数小、下载平平。除非发生剧变,ChatGPT 是唯一走向"核心工具"的 AI 应用。
结论
AI 应用周活破 10 亿,ChatGPT 占 70%,是唯一以真正消费互联网规模运营的 AI 应用,约三年内达到 8–9 亿周活且没有既有分发平台。Google 是真实但遥远的第二:Gemini 2–2.5 亿周活是唯一把下载转成持久使用的其他应用,主要靠 Android、搜索和 40 亿现有用户。其他人都不接近。但并非所有使用都等价。消费市场里一旦一个产品同时拥有安装基数和新用户流量,默认结局是进一步集中。ChatGPT 两者都有。接下来的问题是这些使用是在深化为真正的习惯,还是仍像"来一下就走的工具"。这是第二篇的主题。
№ 17 2026-03-10 1,636 词
消费级 AI 现状(二):参与度与留存
The State of Consumer AI. Part 2: Engagement and Retention
副题:使用量上头条,习惯建帝国。
阅读英文原文 ↗
BLUF · 一句话概要 ChatGPT 不仅最大,也最黏,而且越来越黏:DAU:MAU 是 Gemini 的两倍多,WAU:MAU 从 50% 升到 82%,第 4 周留存从约 40% 升到 66%,并且是数据集中仅有的三个呈"微笑曲线"的产品之一。
引言
消费市场遵循幂律,每个平台周期都产生一个拿走不成比例价值的赢家:Google 拿走 90% 以上的搜索,Facebook 拿走社交,Apple 拿走移动利润。第一篇显示 AI 同样如此:ChatGPT 约 70%,Gemini 约 20%,其他人争抢残羹。但份额不代表持久。消费科技史上到处是使用量飙升然后消退的产品:Google Wave、Clubhouse(首月 1,000 万下载)、BeReal(App Store 第一),都没有建立习惯。一个月出于好奇打开一次的用户,与每天出于习惯打开的用户根本不同。真正的问题不是谁用户最多,而是谁的习惯性用户最多。
结论先行:ChatGPT 不仅是最大的 AI 应用,也是最黏的,而且越来越黏。 三年参与度与留存数据的三个发现:
ChatGPT 的参与度领先幅度大于其在 AI 同行中的份额领先。 放大看,ChatGPT 的参与度好于多数企业应用(Slack、Gmail、Outlook),与 Facebook、Spotify、X 等消费常青树持平。 留存同样:显著好于 AI 同行和顶级企业应用,正稳步向最佳消费平台靠拢。 1. 参与度领先大于份额领先
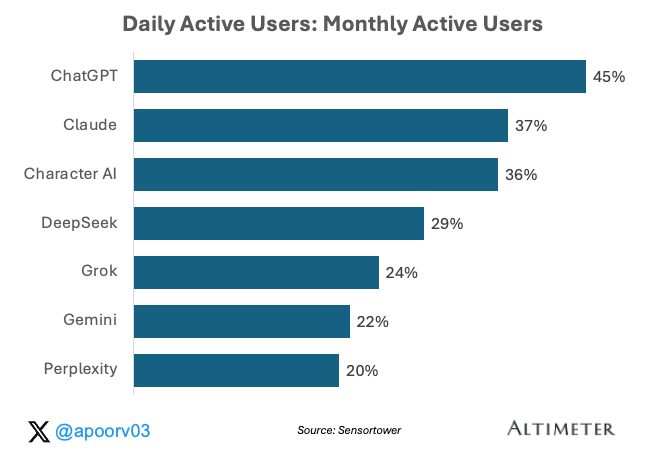
原文配图 DAU:MAU 对比日参与度(DAU:MAU):ChatGPT 45%,Gemini 22%,差距超过 2 倍。Gemini 财报披露 7.5 亿 MAU 令人印象深刻,但 MAU 只说明一个月内有多少人试过,DAU:MAU 说明多少人真把它当作日常的一部分。在这个指标上 ChatGPT 处于另一个联赛。
2. ChatGPT 进入消费级参与度区间
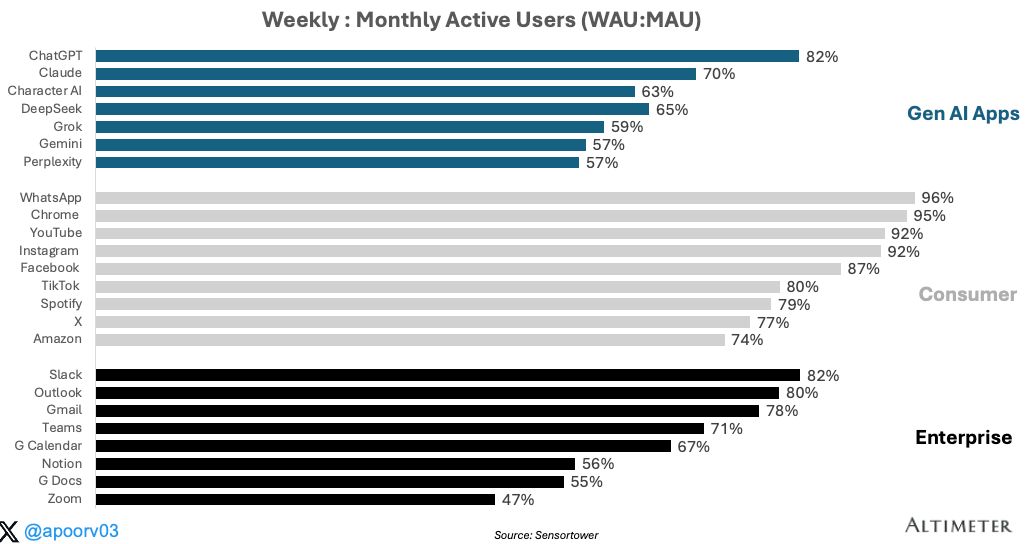
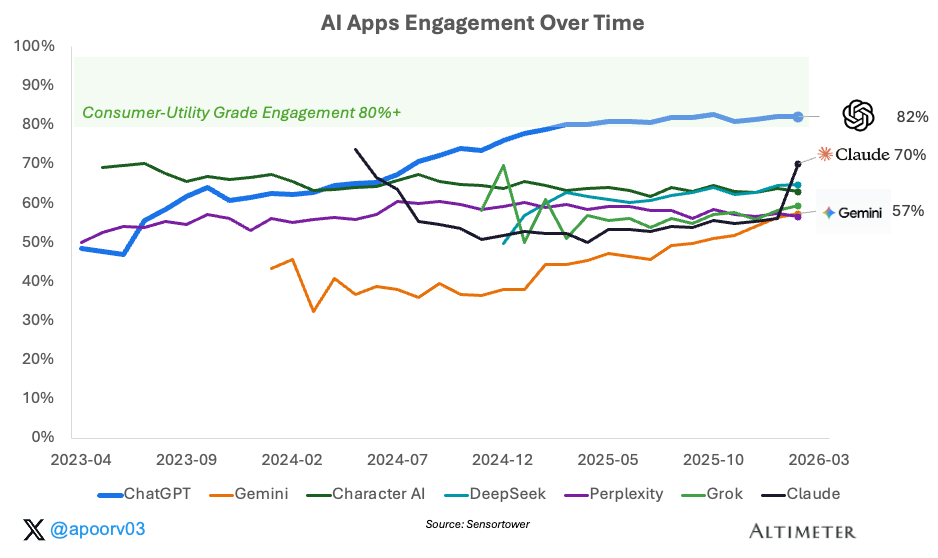
原文配图 WAU:MAU 与成熟应用对比用 WAU:MAU 与成熟消费和企业应用比较,因为它更贴合知识工作的节奏(人们一周用几天企业应用,不是每天)。参照:WhatsApp 96%,Instagram 92%,Gmail 78%,Spotify 79%。ChatGPT 好于 Gmail 和 Spotify、接近 Instagram。对一个只有三岁、没有社交图谱、没有通知驱动的信息流、没有会自己填满的收件箱的产品来说,这非常了不起。而且在改善:2023 年中 ChatGPT 的 WAU:MAU 约 50%,作者当时断言应用需要 80% 以上才能到十亿用户,且几十年的数据显示参与度水平由品类和核心价值主张决定。ChatGPT 打破了这个规律:如今 82%,提升 30 多个百分点。其他 AI 应用无一接近,只有 Claude 似乎在追赶(过去一个月大幅跃升,是安静的亮点)。
原文配图 ChatGPT 的 WAU:MAU 三年变化含义:ChatGPT 不再像 AI 猎奇,而像人们每周依赖的工具。它的行为像工具而非社交应用:人们不是为多巴胺刷它,而是因为需要它才打开。
3. 微笑曲线:ChatGPT 越来越黏
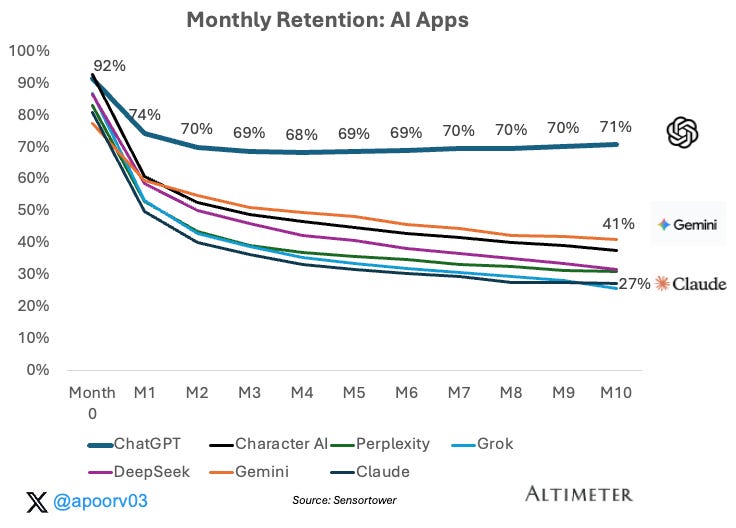
参与度说明给定窗口内人们回来的频率,留存说明他们是否留下。消费产品最罕见的信号是能否赢回已经离开的用户。留存曲线有三种形态:下滑、走平、微笑。微笑曲线(留存先降后升)最罕见,很可能反映产品改进把用户拉回来。
原文配图 三种留存曲线形态数据集中只有 Gmail、ChatGPT、Chrome 呈真正的微笑曲线。WhatsApp、Instagram、TikTok、Spotify、Slack、Outlook、YouTube 都是走平或下滑:它们留得住人,但赢不回人。ChatGPT 在 9 亿周活规模上做到了,说明 OpenAI 的产品迭代节奏(语音、视觉、Canvas、搜索、记忆)不仅吸引新用户,还激活流失用户。
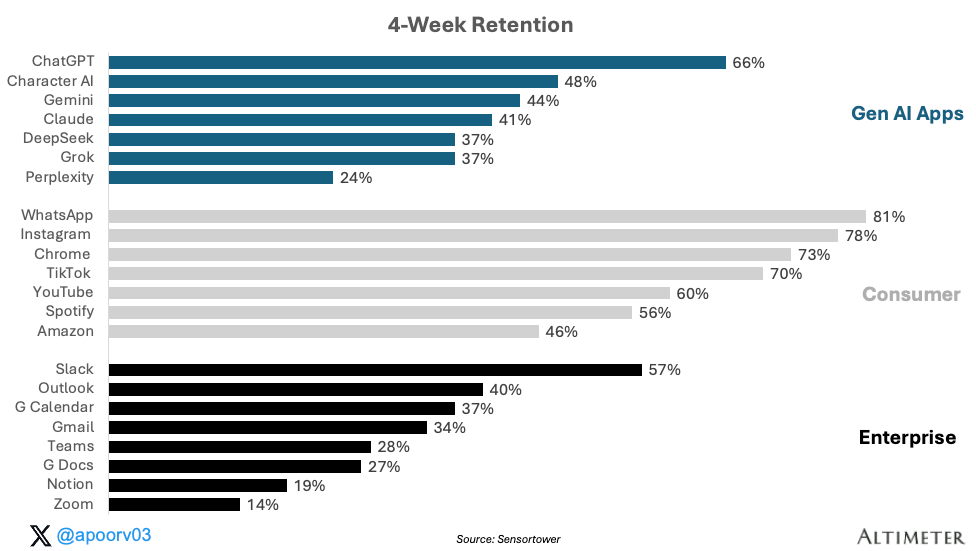
起点已经很高 :第 4 周留存约 66%,三个下载者中两个四周后仍活跃。AI 同行差距明显:Character AI 48%,Gemini 44%,Claude 41%,Perplexity 24%。66% 是在建立安装基数,24% 是在移动端仍难以建立安装基数。与成熟应用比,ChatGPT 第 4 周留存超过数据集中所有企业应用含 Slack,落后顶级消费工具(WhatsApp、Instagram、Chrome),与 TikTok 同区间。两年前的聚类是消费应用右上、企业应用中间、AI 应用左下;ChatGPT 已从 AI 簇迁出,进入企业区,逼近消费区。
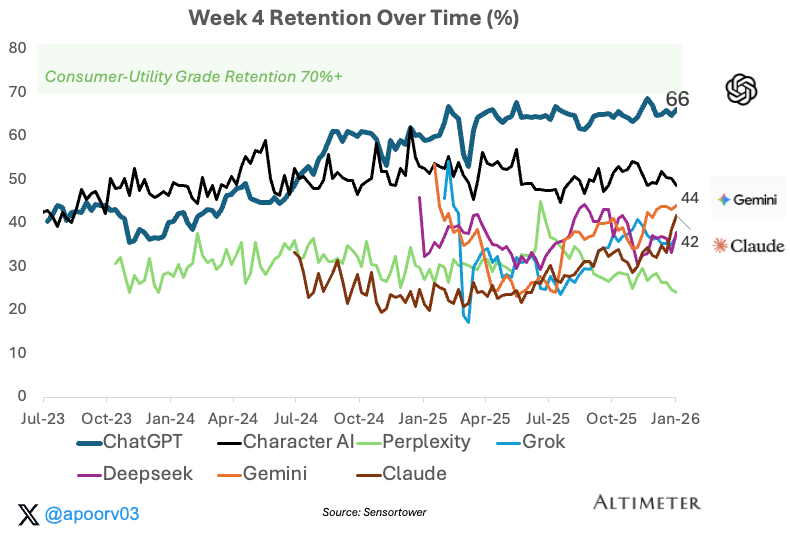
原文配图 第 4 周留存率对比规模化中留存反而改善 :三年前 ChatGPT 第 4 周留存接近 40%,如今 66%,提升约 25 个百分点。多数应用留存早早定型,随用户基数成熟、休闲用户涌入而走平或下滑;ChatGPT 用户增长 10 倍,留存反而变好。最可能的解释是产品改进:每次重大发布都给了用户回来的新理由。这让微笑曲线可信:它不是从弱起点恢复,而是从已经很强的底线恢复,同时还在增加数亿用户。这种组合真正罕见。
原文配图 ChatGPT 第 4 周留存的三年变化结论
ChatGPT 不再只是最大的 AI 应用,它正成为互联网上最黏的产品之一:高周参与、强早期留存、大规模下仍在改善的黏性。这不是新鲜感,是习惯养成。在消费科技里,习惯是区分"触达"与"收入"的东西。一个 9 亿周活且留存在改善的产品,不只是赢得注意力,是在建立一个帝国。对竞争者,取代 ChatGPT 的窗口正在收窄,不是因为产品不可战胜,而是习惯在复利:参与度和留存在这个规模上每改善一周,切换成本就上升,引力就更强。第三篇谈时长与商业化。
№ 18 2026-03-16 84 词(播客预告)
对话 ChatGPT 负责人 Nick Turley
Conversation with Nick Turley, Head of ChatGPT
阅读英文原文 ↗
什么推动 ChatGPT 从 0 到 10 亿用户?下一个 10 亿怎么来?作者与 ChatGPT 负责人 Nick Turley 进行了节目中最坦诚的对话之一。话题包括:GPU 分配的取舍、留存微笑曲线、定价、把 "Code Red" 当作一种战略、从 OpenClaw 请来 Peter(steipete),以及 Nick 为何认为好奇心是 AI 时代唯一的"永久技能"(并推荐了 Bill Gurley 的新书)。
№ 19 2026-03-30 2,623 词
消费级 AI 现状(三):时间就是金钱
The State of Consumer AI. Part 3: Time is Money
阅读英文原文 ↗
BLUF · 一句话概要 领先消费级 AI 应用的广告收入机会可能大于订阅。ChatGPT 占 AI 总时长 68%,人均时长三年增约三倍,查询意图比搜索更强;若每位免费用户每年 30 美元广告收入,按当前规模即约 250 亿美元。Google 因为有搜索广告的印钞机,可以暂时让 Gemini 无广告。
框架
前两篇讲 Revenue = Price × Quantity 中的 Q:用户数、回访频率、习惯是否真实。本篇讲 P:到底能收多少钱。时长是两者之间的桥梁。在消费科技里,时间是商业化的原材料:订阅业务把时间转化为感知价值和付费意愿,广告业务把时间转化为广告库存,两者的输入相同,即你的产品占据用户一天中的多少。
结论先行:领先消费级 AI 应用的广告收入机会可能大于订阅机会。 原因很简单:消费级 AI 正在积累驱动最大互联网企业的同一种原材料,时间和注意力。广告收入 = 总时长 × 广告量 × 广告单价。数据显示:
AI 应用总时长在爆炸,心智份额与用户数一样呈幂律,即使按人均时长调整。 人均时长上升,意味着大且增长的广告量。AI 应用落后消费基准,但开始比肩企业应用;ChatGPT 更像工作与生产力工具而非社交信息流,这是有能力逐步提高广告负载的强信号。 ChatGPT 查询的意图信号比搜索更强,意味着有吸引力的广告定价。 1. 总时长:ChatGPT 占消费级 AI 注意力的 68%
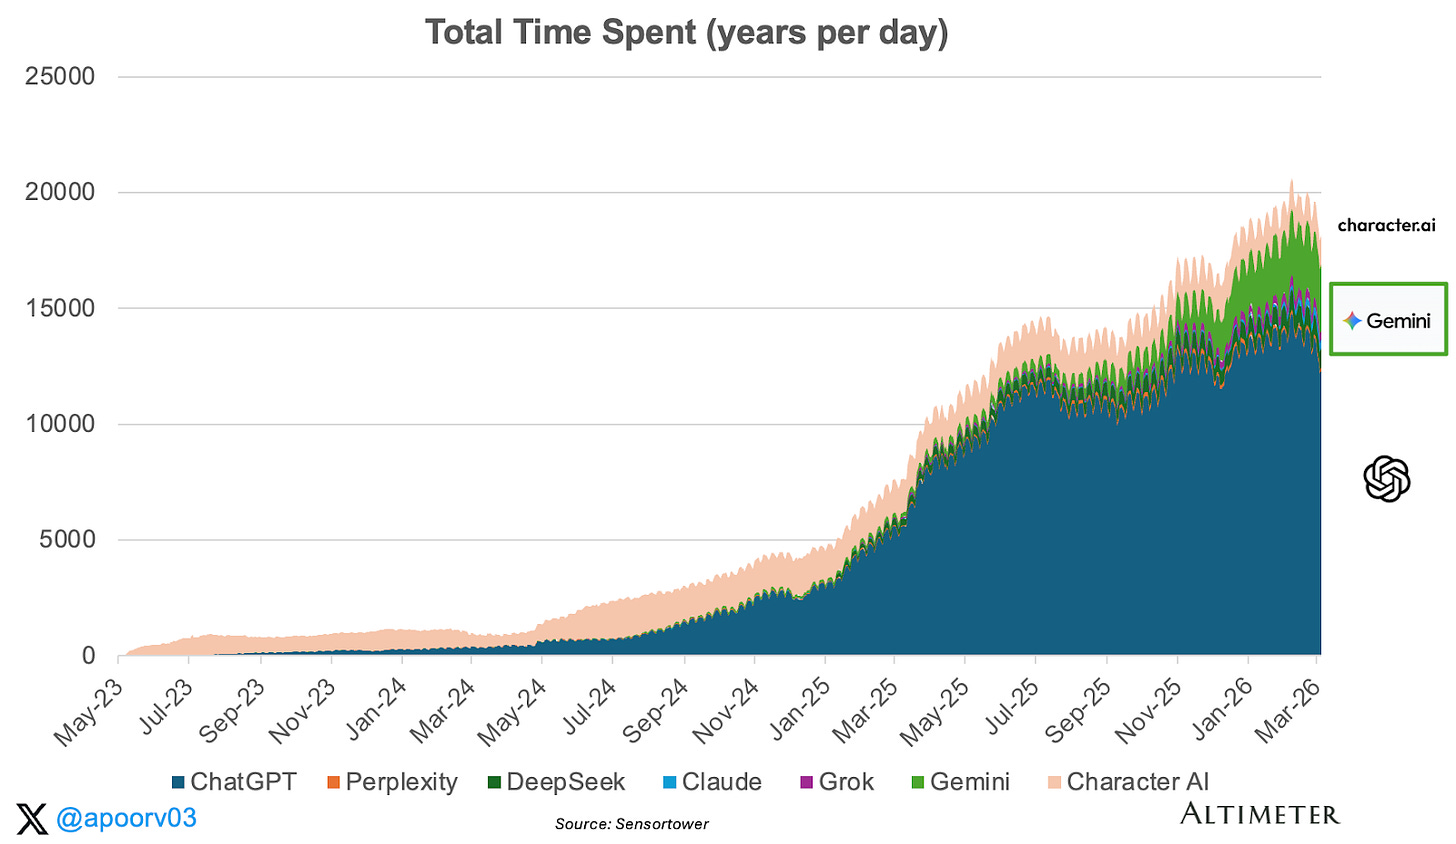
原文配图 生成式 AI 应用总时长生成式 AI 应用总时长两年增约 10 倍,仅 2025 年就增 3.6 倍。2025 年 1 月前后的拐点显著:上半年总时长约翻倍,由 ChatGPT 扩展到语音、图像生成和搜索驱动。Gemini 2024 年中出现并显著增长,但远居第二。
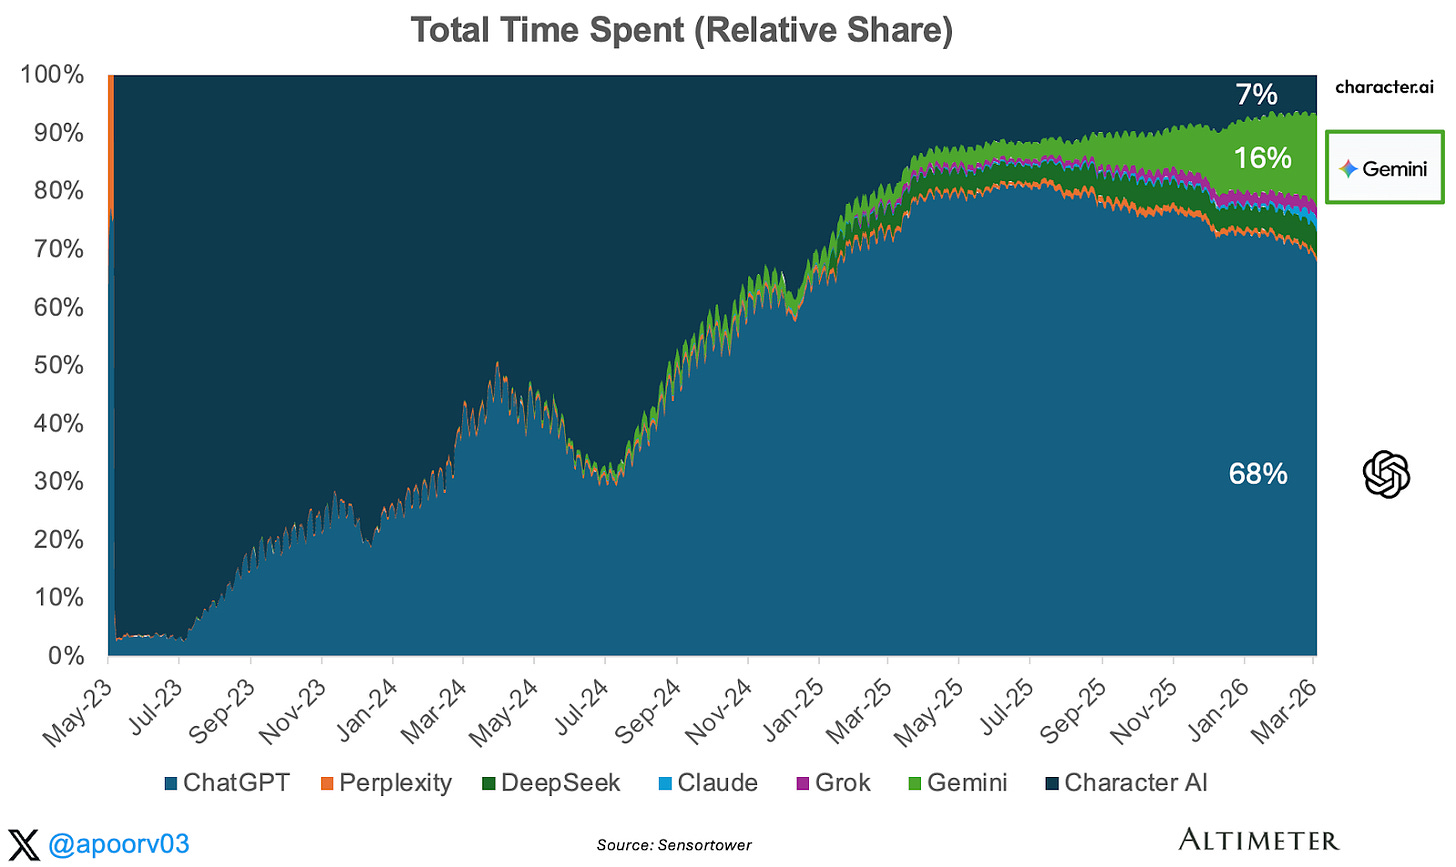
原文配图 AI 总时长份额ChatGPT 占总时长 68%,Gemini 16%,其余合计约 16%。这种集中使 ChatGPT 成为第一个规模化 AI 原生广告业务最可能诞生的地方,也解释了 OpenAI 为何比同行更早更激进地试验商业化:广告无法在规模不足的平台上做。用户花时间的地方就是广告主可用的地产,其中 68% 在一个产品里。
2. 人均时长上升,广告表面更大
原文配图 各 AI 应用人均时长趋势图上每个 AI 应用都在上升。ChatGPT 自 2023 年初人均时长约翻三倍,Claude、Gemini、Grok 过去一年陡升。人们不只是下载然后离开,而是在 AI 应用里花更多时间。
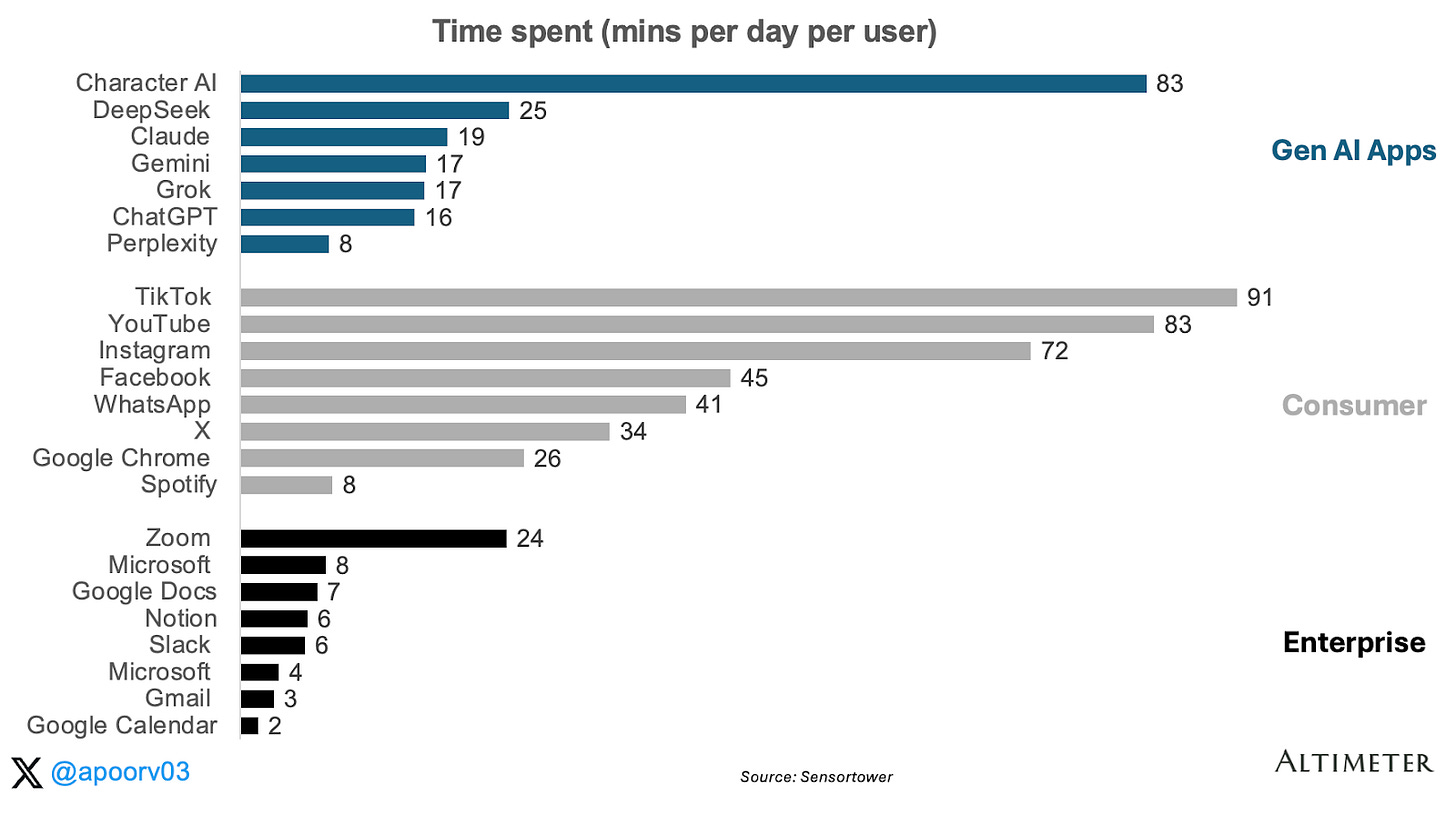
原文配图 人均每日时长:AI 应用 vs 消费与企业应用与消费应用比仍低得多 :ChatGPT 每天 16 分钟,远低于 TikTok、YouTube、Instagram。但这不是公平比较,因为 ChatGPT 缺少驱动消费应用海量时长的两样东西。其一,没有社交网络效应:TikTok 和 Instagram 之所以黏,部分因为你的朋友、创作者和社区在那里,内容个性化且由你关注的人生成;ChatGPT 没有信息流、没有粉丝、没有社交图谱。其二,没有多巴胺循环:社交应用为可变奖励而设计,你永远不知道下一次滑动是无聊还是搞笑;AI 助手相反,带着具体任务来,拿到答案就走。
与企业应用比高于多数 :注意这是 Sensortower 的仅移动端数据,Slack、Gmail、Google Docs 等桌面重的产品被低估。即便如此,仅在移动端 ChatGPT 已像一个高频生产力工具。这很重要,因为生产力产品在远低于娱乐应用的时长水平上也能很好地变现:Slack 每用户每月收 7–12 美元。如果 AI 助手已在消费规模上捕获这种程度的日常注意力,变现的表面是可观的。人均时长上升对收入方程意味着两件事:支撑订阅付费意愿的感知价值更高,可投放广告的表面更大。
3. 收入机会
3a. 广告为何能超过订阅 :重点不是订阅弱,而是最大的消费互联网企业历史上通过广告变现的收入远超订阅。
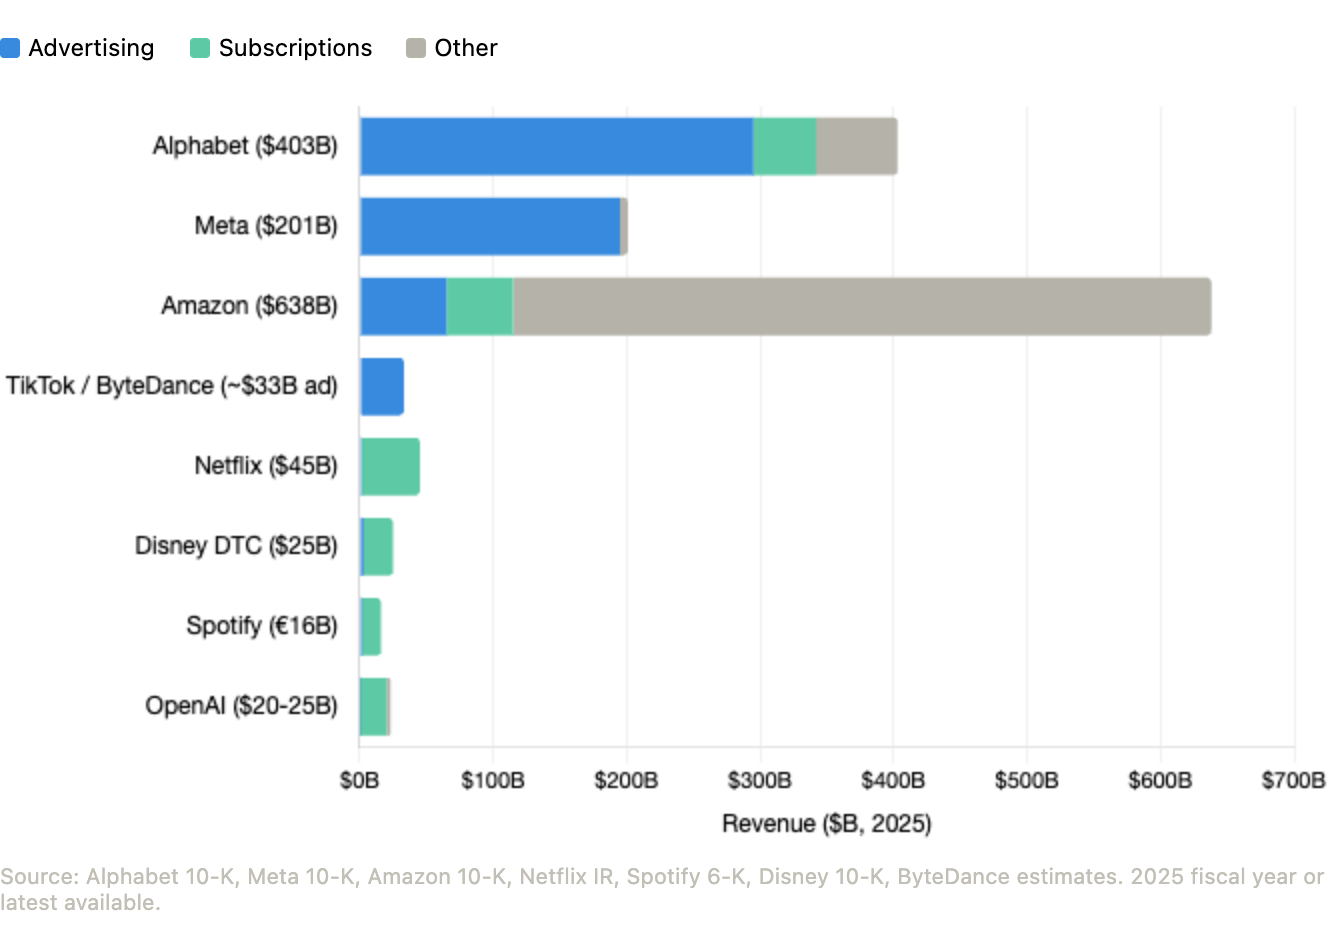
原文配图 广告收入 vs 订阅收入的量级对比Google 的广告业务约为 Netflix 收入的 5 倍,Meta 约 4 倍,连十年前几乎不存在的 Amazon 广告如今也大于 Netflix。更高的订阅 ARPU 能否弥补更小的付费基数?对一些企业可以,但在规模上,广告更大的变现基数往往赢。
原文配图 同时拥有两种模式的公司:广告与订阅Alphabet 和 Amazon 两种模式都有,两家都是广告更大且增长更快;Netflix、Disney、Spotify 几乎全订阅,Meta 和 TikTok 几乎全广告。OpenAI 今天几乎全是订阅收入,只在美国一小部分免费用户上试点了广告(年化已超 1 亿美元)。95% 的用户免费,这是一个目前几乎零收入的巨大注意力池。OpenAI 是先行者,但同样的免费用户变现问题适用于每个有大量免费用户的 AI 应用。
3b. AI 注意力如何定价 :
总时长:ChatGPT 约 9 亿周活,DAU:MAU 45%,移动端每天约 16 分钟。 广告量是产品决策:Google 每页搜索结果 3–4 条广告,Meta 每 3–5 条帖子一条广告,ChatGPT 目前每次对话最多一条,且仅对约 5% 的移动用户。克制是为了保护信任,但意味着这个变量目前极低。 广告单价(CPM)取决于一个问题:"这个用户会不会买东西",分解为意图(用户是否在做决策)、归因(广告主能否追溯到购买)、受众质量(是否有消费力)。Google 搜索意图强,有人输入"2026 最佳房贷利率"就是实时的商业意图声明,CPM 15–200 美元以上,全球人均年收入约 84 美元。Meta 意图弱但时长巨大,每天 30–90 分钟,靠从行为和人际图谱推断意图的极致定向补偿,人均约 57 美元。YouTube 居中:中等 CPM、长会话、视频创意。总结:Google 卖意图,Meta 卖注意力,YouTube 卖观看时长。 3c. AI 助手的位置:ChatGPT 案例 :ChatGPT 的广告定价可能更接近 Google 而非 Meta,在对话上下文提升商业意图的品类中甚至更有优势。用户让 ChatGPT 推荐笔记本、比较保险方案、规划家庭旅行时,交互像搜索但上下文更丰富:常在一个提示里给出预算、偏好、约束和意图,商业信号对广告主更清晰。作者预期 ChatGPT 的实际 CPM 至少与 Google 搜索相当,某些品类更高。早期数据支持:OpenAI 高端广告位定价约 60 美元 CPM,远高于展示广告,处于高意图搜索区间。ChatGPT 约 8–9 亿免费用户(周活的 95%)。若每位免费用户每年 30 美元广告收入,按当前规模即 250 亿美元;参照 Meta 的 57 美元和 Google 的 84 美元,对一个高意图、已登录的产品而言 30 美元并不激进。
早期数据显示对信任指标没有影响,但测试尚早。把广告扩大 20 倍而不损害建立起习惯的体验,是真正的执行挑战。机会尚未验证的主因:并非所有 AI 时间都是商业性的,相当部分 ChatGPT 使用是信息、创作或生产力用途而非交易;且对话界面不像信息流或搜索结果页那样有明显的广告位。上行是真实的,执行约束同样真实。也有更乐观的可能:AI 不只创造广告库存,还能创造全新的广告形式。对话式广告把产品推荐织进对话而非贴在旁边,可能改善而非损害体验:让 ChatGPT 规划周末旅行时,基于你的偏好和记忆浮现一个相关的酒店优惠,这不是打断,是功能。若 AI 带来超个性化、代理行为和与品牌的真正对话时刻,广告机会不仅大,还可能与现有任何广告体验都不同。
3d. Google 为何可以等 :Google 多次表示无计划在 Gemini 投放广告。1 月达沃斯上 DeepMind CEO Demis Hassabis 说他对 OpenAI 急于在 ChatGPT 上广告"感到惊讶";Google 广告副总裁 Dan Taylor 2025 年 12 月称"Gemini 应用没有广告,目前也没有改变的计划"。这是只有 Google 负担得起的战略奢侈:它已有 2,950 亿美元的搜索广告印钞机,可以把 Gemini 当作亏损引流产品,用无广告体验扩大用户并加深参与,同时通过既有搜索基础设施变现 AI(AI Overviews 和 AI Mode 已带广告)。OpenAI 没有这种奢侈,没有可倚靠的现金牛,必须直接在聊天界面变现。Gemini 目前只靠订阅,人均收入机会远小于 OpenAI 的广告加订阅。但 Google 在玩不同的游戏:保护助手以留住用户,同时激进变现搜索结果页。随着免费用户推理成本上升、Gemini 用户基数超过 7.5 亿 MAU,这一策略能否维持是开放问题;某个时点,运营一个巨大免费 AI 助手的经济学可能迫使 Google 出手。
综合
这个系列问的是消费级 AI 只是大量使用,还是正在成为真正的生意。第一篇讲触达,第二篇讲习惯,第三篇说明变现机会可能比很多人以为的大。被低估的一点是,以 ChatGPT 为首的领先 AI 助手已经拥有最大消费互联网企业最擅长变现的属性:规模化、经常性的注意力。约 95% 的周活仍免费,意味着这些注意力今天几乎未变现。这不保证 Google 或 Meta 级的广告业务:对话界面更难干净地变现,信任是产品最宝贵的资产。但若 OpenAI 能证明广告可以住在高意图助手里而不破坏体验,长期广告机会可能大于订阅业务。届时 Google 真正的战略问题将不再是 Gemini 是否该保持无广告,而是它还能承受多久。(作者感谢 Sarah Friar 和 Fidji Simo 审阅本文及本系列草稿。)
№ 20 2026-04-01 1,471 词
生成式 AI 的经济学:两年之后
The Economics of Generative AI: Two Years Later
副题:半导体是单人游戏,应用是双人游戏,基础设施是唯一有竞争的层。
阅读英文原文 ↗
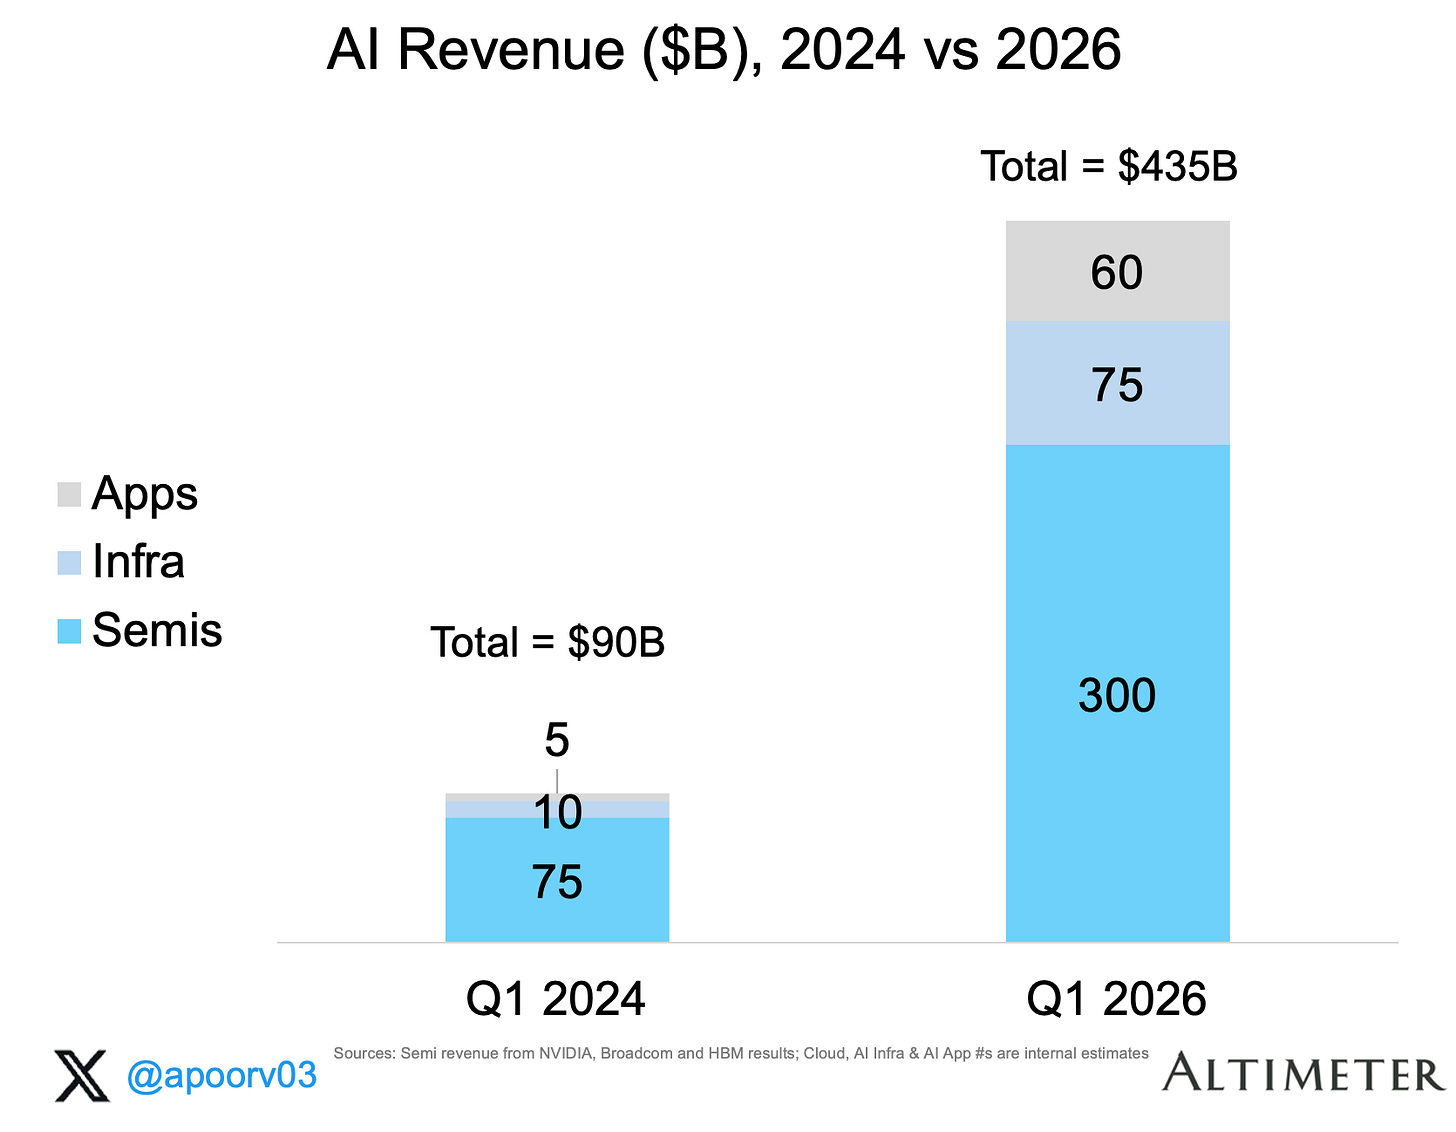
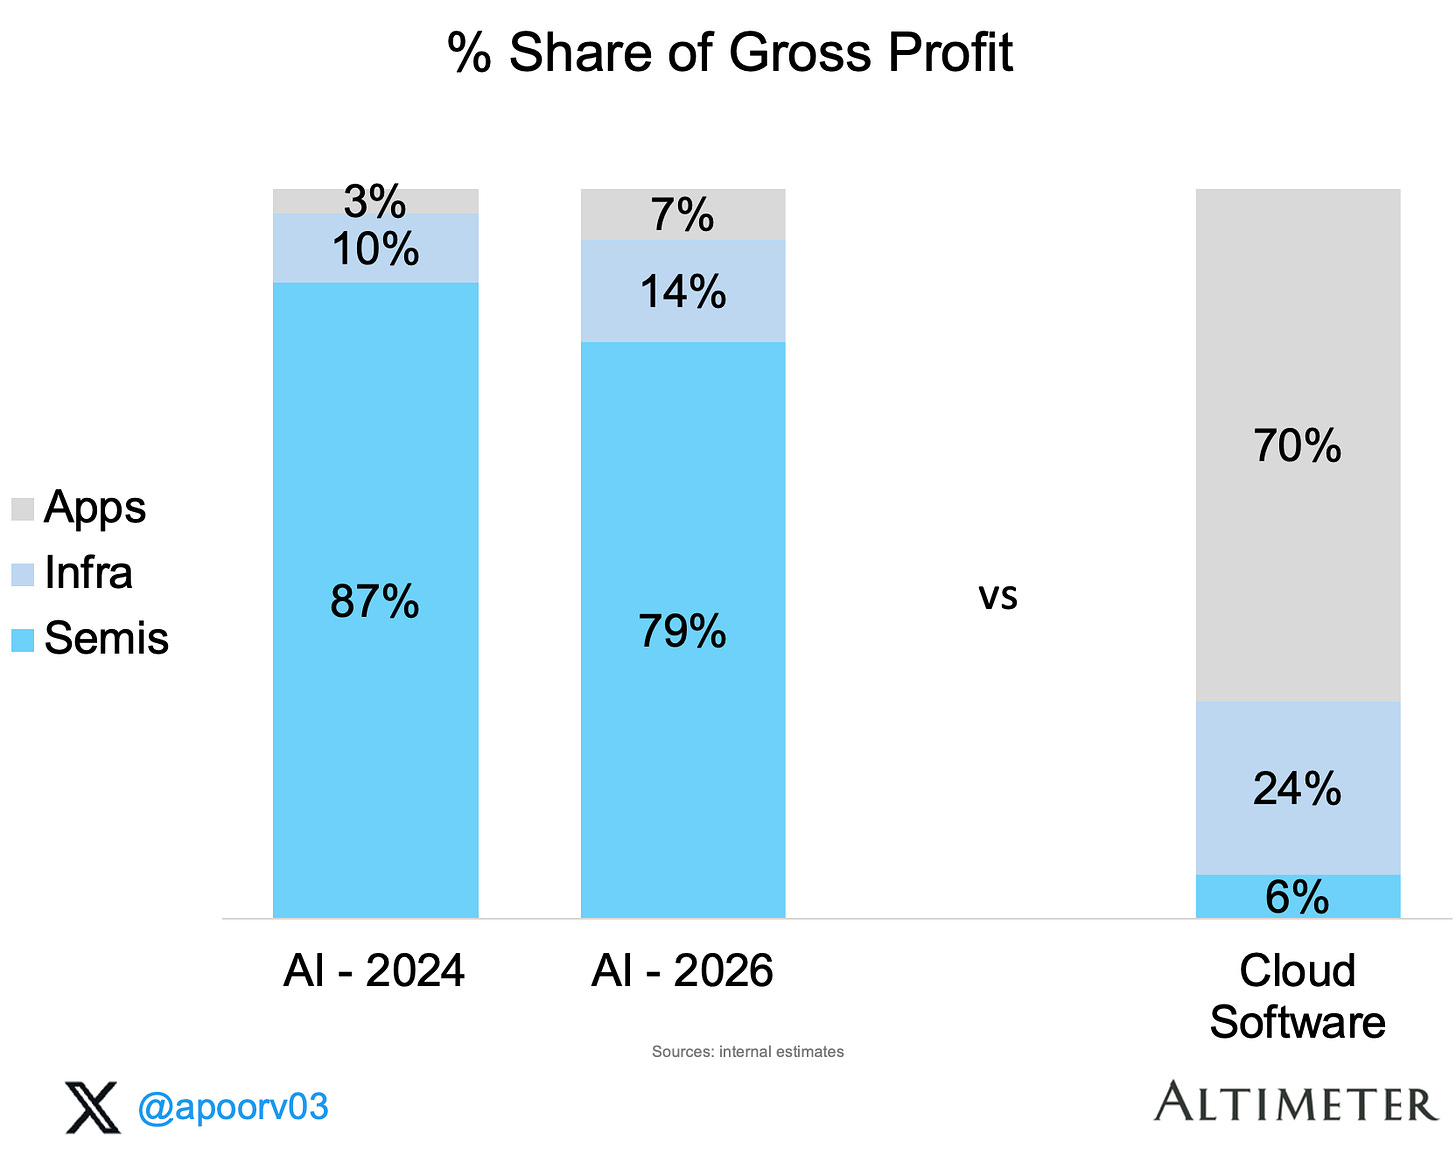
BLUF · 一句话概要 AI 生态两年增长 5 倍(年化营收约 900 亿到约 4,350 亿美元),但价值链形态几乎没变:半导体层仍占约 70% 营收和 79% 毛利,NVIDIA 一家新增的收入约为整个应用层的 3 倍;堆栈终将翻转,但可能需要超过十年。
回顾
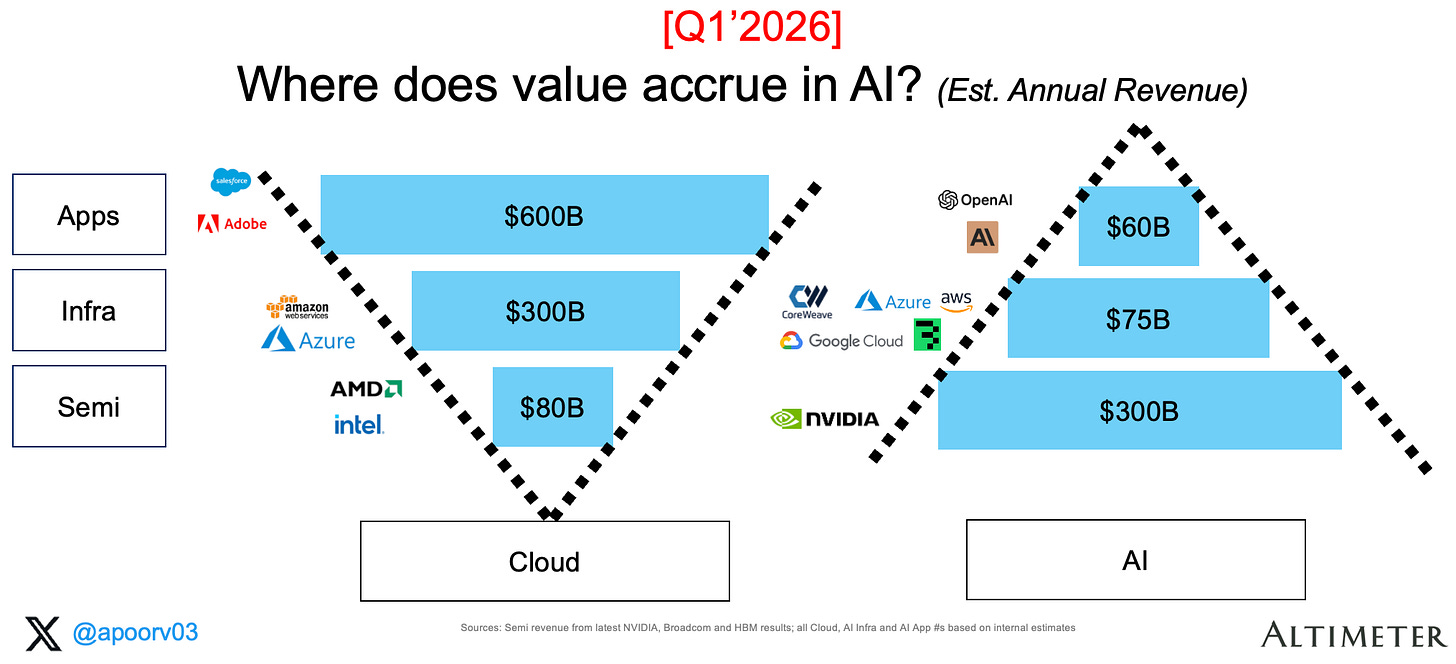
这是作者最常回看的一篇分析,因为它提醒 AI 行业的"物理定律"。两年前的发现是价值链倒挂:算力层拿走约 83% 的营收和约 87% 的毛利,离终端客户最近的应用层几乎不赚钱。作者当时预测会像每次平台转移一样翻转。
原文配图 2024 年原文的预测两年过去,AI 生态增长约 5 倍,但经济形态变化很小。结论先行:半导体是单人游戏,应用是双人游戏,基础设施是唯一有竞争的层。AI 里最赚钱的策略仍然是卖铲子。
#1 价值链仍然倒挂
原文配图 2026 年 AI 价值链各层营收半导体(约 3,000 亿美元) :绝大部分是 NVIDIA,其数据中心业务上季 620 亿美元,年化约 2,500 亿。Broadcom 的 AI 半导体(为 Google、Meta、ByteDance 定制加速器)约 340 亿。超大规模云厂商为自研芯片项目直接采购的高带宽内存约 250 亿。集中度极端:NVIDIA 约占该层 80%。基础设施(约 750 亿美元) :AI 专属云基础设施。Azure、AWS、GCP、Oracle 各贡献 100–200 亿 AI 相关收入,CoreWeave 约 60 亿,Baseten、Together、Modal 等推理提供商构成其余。与其他层不同,这一层在主要云之间分布相对均匀。应用(约 600 亿美元) :同样极度集中,但集中在两家公司。OpenAI 和 Anthropic 合计年化约 450 亿,占该层约 75%。遥远的第三是 Cursor 等编码 AI,其后是 ElevenLabs、Glean、Sierra、Perplexity、Replit、Lovable、Harvey、Abridge 等快速增长的 Agent 公司。半导体层仍占全部 AI 营收的约 70%。 云堆栈中半导体只占约 8%,十分之一。这个差距是本轮超级周期与上一轮之间的核心扭曲。
#2 AI 增长 5 倍,但 NVIDIA 拿走大部分价值
应用层按百分比增长最快,两年 12 倍。但按绝对值,半导体层增加约 2,250 亿美元,应用层增加约 550 亿;NVIDIA 一家增加 1,750 亿,约为整个应用层今天规模的 3 倍。
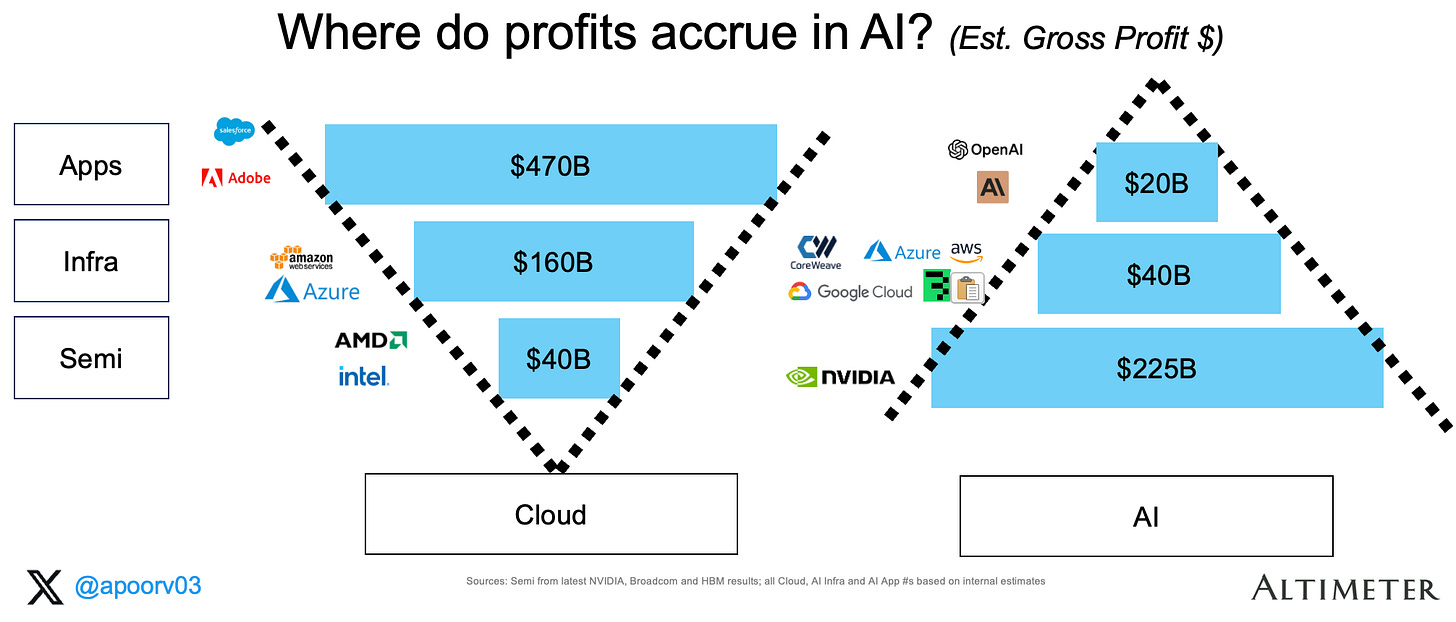
原文配图 两年间各层营收增长利润更偏斜:毛利率半导体约 73%,基础设施约 55%,应用约 33%(作者估算)。
原文配图 各层毛利率相乘得毛利额:半导体约 2,250 亿,基础设施约 400 亿,应用约 200 亿。半导体占 AI 生态全部毛利的 79%。 对比云堆栈:应用占 70%,半导体占 6%。AI 堆栈几乎是镜像。两年间基础设施和应用各增约 4 个百分点的利润份额,半导体从 87% 降到 79%。按这个速度,应用层要达到云时代那样的份额需要远超十年。
原文配图 各层毛利份额的变化#3 资本开支值得吗
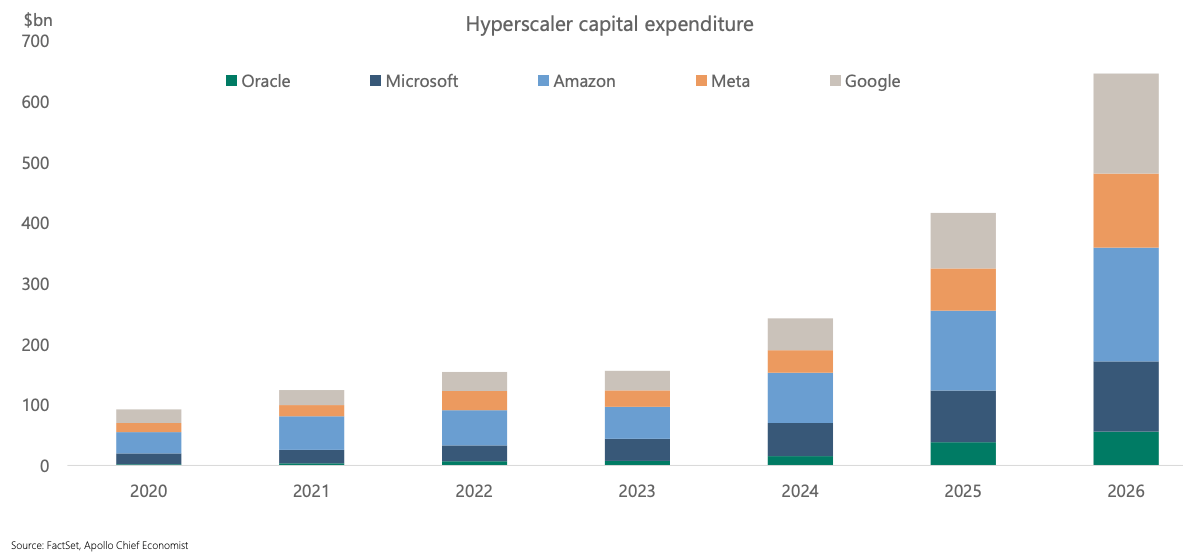
前五大超大规模云厂商 2025 年资本开支约 4,430 亿美元,较 2024 年的 2,560 亿增长 73%;2026 年预计超过 6,000 亿,约 75%(约 4,500 亿)投向 AI 基础设施。
原文配图 超大规模云厂商资本开支这些资本开支能否产生正回报?CEO 们在押注:
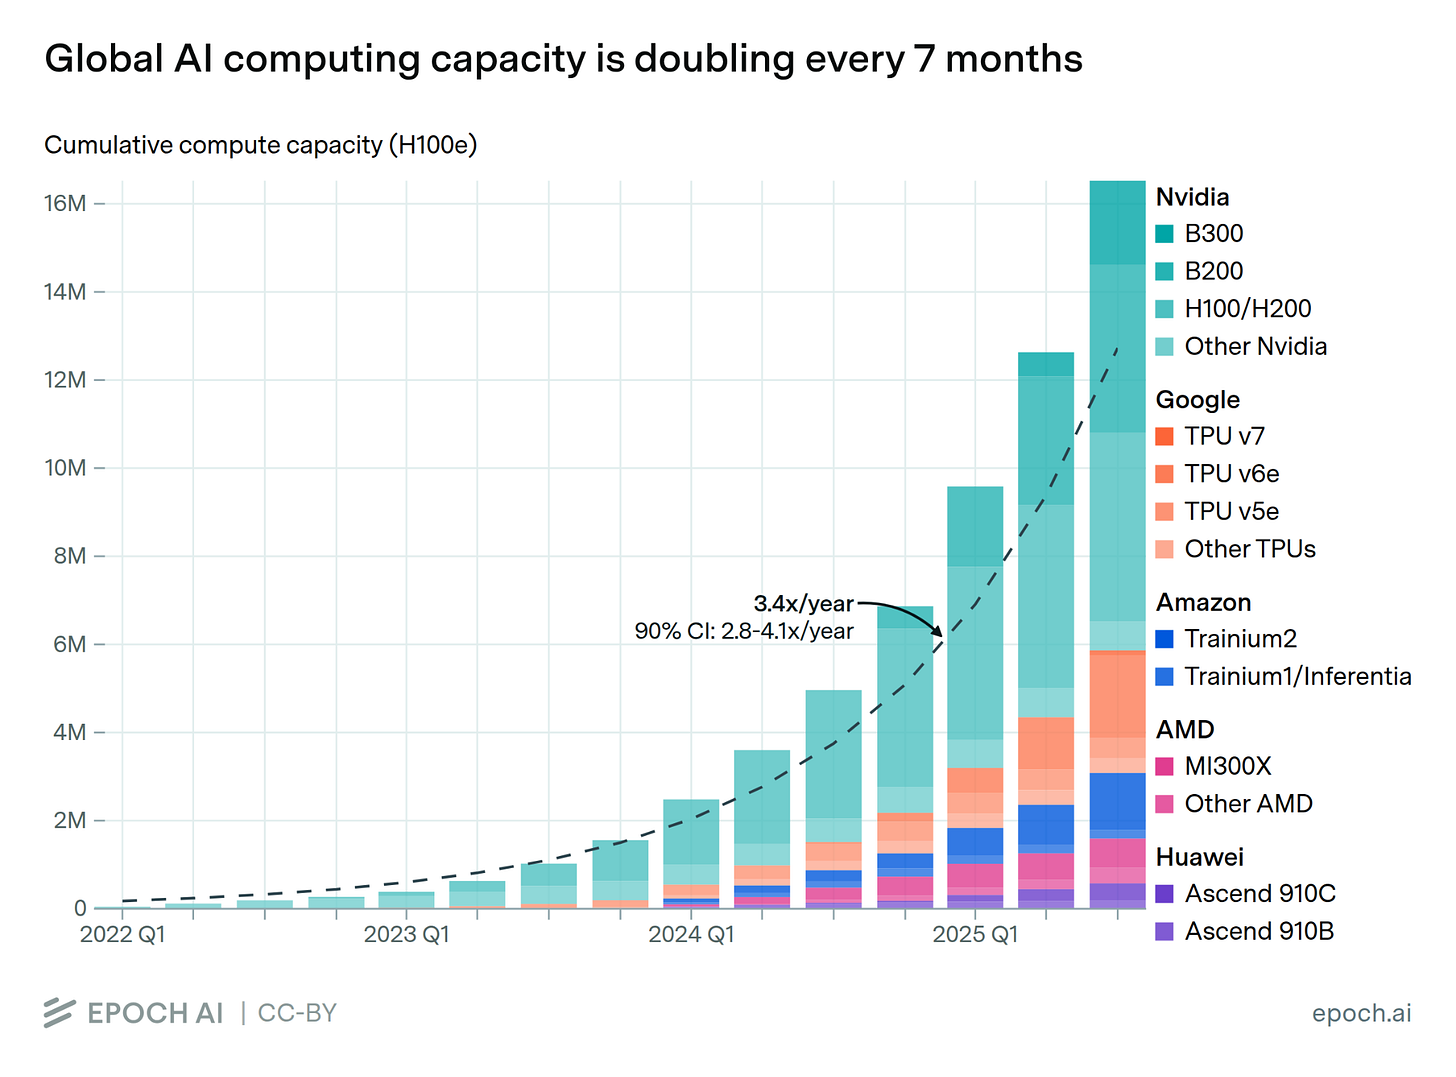
Andy Jassy(Amazon,2026 年 2 月):"我们增加产能有多快,变现就有多快。" Sundar Pichai(Alphabet,2026 年 2 月):AI 投资和基础设施正在全面推动收入和增长;但他也承认当前 AI 投资规模存在"非理性成分"。 Mark Zuckerberg(Meta,2026 年 1 月):激进前置建设产能是正确策略,最坏情况只是放缓新建一段时间,等业务长进已建的产能。 按芯片类型看累计 AI 算力(以 H100 当量计,来源 Epoch AI),压倒性地是 NVIDIA,非 NVIDIA 芯片开始在边缘出现。
原文配图 Source: Epoch AI。累计算力以 H100 当量计每家超大规模云厂商都在用自研芯片对冲,按成熟度排序:
Google TPU (最成熟):第七代 Ironwood 正式可用;Anthropic 订购多达 100 万颗 TPU,价值数百亿美元;Google 开始把 TPU 作为商用硬件出售;据报道 TPU 的竞争压力迫使 NVIDIA 对部分客户降价约 30%。Amazon Trainium (快速扩张):已部署 140 万颗 Trainium2,承载 Bedrock 大部分推理;据 Amazon,自研芯片业务年化超过 100 亿美元,三位数增长;Trainium3(3nm)投产,产能几乎全部预订至 2026 年中。OpenAI 定制 ASIC (新玩家)加 AMD :与 Broadcom 签多年协议,2026 年起交付 10GW 定制加速器;另与 AMD 签 6GW 的 Instinct MI450 GPU。Microsoft Maia 加 AMD :2026 年 1 月在 Azure 部署 Maia 200,宣称推理性能是 Trainium3 的 3 倍,已承载部分 ChatGPT 负载;Nadella 表示仍会向 NVIDIA 和 AMD 采购。Meta MTIA (仅内部):MTIA v3 用于内部推理;2025 年 9 月收购芯片初创 Rivos,获取面向 2026 年的 RISC-V 设计。Jensen Huang 把定制 ASIC 斥为"没有竞争力",称"很多 ASIC 都被取消了"。从历史看他没说错。
#4 堆栈终将翻转,但可能超过十年
原文配图 堆栈翻转的时间线作者仍相信会翻转,只是对时间不那么确定。要翻转,要么应用层持续爆发,要么半导体变便宜。两者都在发生,但都不够快到在本十年内改变形态。云堆栈从硬件主导到软件主导用了约 15 年,AI 可能类似。自研芯片是关键变量:若 TPU、Trainium 和其他 ASIC 规模化成功,可压缩 NVIDIA 的毛利并把利润上移;但除 Google 的 TPU 外,尚无定制芯片项目证明能在训练负载上规模化地与 NVIDIA 竞争。最大的开放机会仍在应用层,那也是作者花最多时间的地方。但投资者和建设者应清醒认识今天的经济学:AI 里最赚钱的公司,仍然是卖铲子的那家。
№ 21 2026-06-22(2026-07-28 更新,补充 Decagon 数据) 1,580 词
我们为什么加倍押注 Baseten
Why we are doubling down on Baseten
阅读英文原文 ↗
BLUF · 一句话概要 投资六个月后,Baseten 在 Q1 末就超过了当初承保的 2026 全年预测。更新后的论点:推理将成为世界上最大的市场;后训练的开源模型在能力、成本、控制上组合最优;Baseten 提供驾驭开源的完整"模型供应链";Baseten 是 AI 经济的指数。
推理将是最大的市场
有些真理大到需要反复说。如果 2003 年写"互联网会很大",正确的做法不是 2004 年就收回这个观点,而是继续说,因为量级仍被低估。作者对推理也是如此:认为它到本十年末会成为世界上最大的市场,不是最大的软件市场,是最大的市场。原因是它是 AI 经济的基本原语:训练创造模型,推理服务产品。最简单的类比是电表:AI 产品每做一次有用的工作,电表就转。用户看到的是软件,底下是持续的模型调用流。更多用户、更长提示、更大上下文窗口、更多推理步骤、更多工具、更多 Agent、更多重试、更多评估、更多个性化,全部变成更多推理。早期 AI 产品多为单轮,下一代是循环:检索、推理、调工具、检查结果、重排、合成、验证、再重复,一次用户操作可产生数百上千次推理事件。Google 的公开 token 数据是有用的方向性信号:两年前每月 9.7 万亿,去年约 480 万亿,I/O 2026 宣布超过 3.2 千万亿。这只是 Google 自家的栈和表面,不是整个市场,但足以说明推理在以惊人的速度复利。
原文配图 Google 每月处理 token 量的增长后训练的开源模型在能力、成本、控制上组合最优
"开源与闭源"常被当作宗教辩论。闭源前沿模型很出色,常是最智能任务、最难推理任务、模型即服务的便利性以及新能力探索的正确选择。但 AI 原生公司的实际问题不同:对这个工作流、这个质量门槛、这个延迟、这个成本、这个安全态势和这个控制程度,最佳的模型架构是什么?后训练的开源模型对特定工作流可能更好:更便宜、更快、可在客户环境中运行、可被私有评估、专有轨迹、领域强化学习和应用框架塑造。
两个因素正在倾斜天平:一是 token 量的指数增长(更多能力带来更多效用,进而更多使用);二是所有权,这是最具战略性的一点。公司意识到模型正在成为承重结构,不想把核心智能租来。
原文配图 Satya Nadella 的推文引 Satya Nadella:公司应能换掉"通才"模型而不失去学习系统里的"公司老兵"专长;企业要把工作流、领域知识和积累的判断变成随使用改进的 AI 系统,这个闭环成为公司的新 IP,像一台爬山机,且与多数资产不同,它会复利。范式从"选最好的模型"转向"构建学习闭环":持久的 IP 是私有数据、私有评估、工作流轨迹、领域反馈、强化环境、产品上下文和随用量改进的模型行为。作者调研的 AI 原生公司呈现的模式是:前沿模型做最难的通用智能,后训练的开源模型做大流量和专业负载,后者让 AI 原生公司拥有自己的智能并复利其最宝贵的资产。
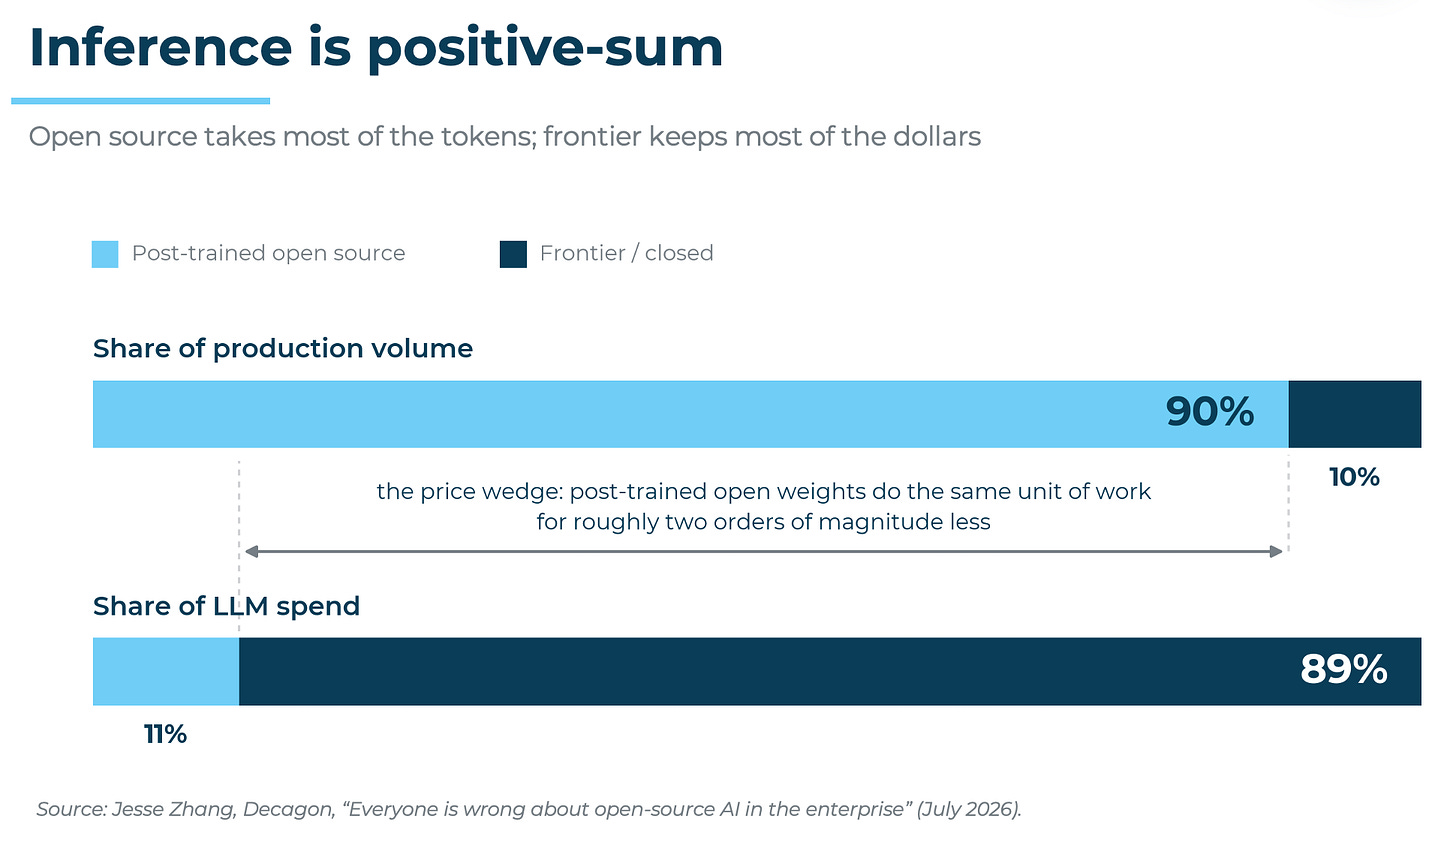
Decagon 的 Jesse Zhang 给出了看待这个分野的方式:Decagon 约 90% 的负载跑在开源上,而开源只占企业 LLM 支出的 11%。分母不同,但指向一个正和市场:开源以低得多的单位成本吸收大量成熟、专业的工作,前沿模型保留最新、最难、支出最高的任务。随着工作流成熟,开源会拿到更多生产流量和越来越大的支出份额,前沿模型继续推进能力并创造下一波需求。
原文配图 Decagon:开源承担的负载份额 vs 支出份额Baseten 模型供应链的实践:Harvey 案例
法律工作高风险、高技能、高度个案化,Harvey 是有用的公开案例。Harvey 描述其模型策略:受 Cursor 的 Composer 启发构建法律基础模型系列,目标是以可负担的价格和强安全态势在全产品提供前沿智能,同时为律所构建专属模型、拥有自己的智能打基础。这就是整个论点浓缩在一个客户模式里:许多专业模型,服务许多专业工作流,嵌在许多专业产品里。
他们围绕实际工作构建模型系统。法律工作往往跨越数月、大量文档、多人、多判断、多中间步骤,Harvey 的 Agent 系统需要阅读、推理、用工具、求助、保持上下文,并在律师实际执行的任务上改进。Harvey 与 Baseten Research 的合作展示了后训练与应用框架如何结合:用法律 Agent 基准和领域任务,把一个开源模型后训练进闭源前沿区间。目标不是在每个基准上打败每个前沿模型,而是在重要的工作流上,以可生产化的成本、延迟和控制交付前沿质量。Harvey 指出前沿模型每任务约 50 美元、延迟约 20 分钟,与 Baseten 的工作展示了以实际得多的成本和延迟达到可比领域质量的路径。
原文配图 Harvey:后训练的开源模型进入前沿区间这是作者最早在 AI 原生公司看到的模式:模型使用成为承重结构后,公司更在意能力、成本和控制这三件事。这个模式正在走向企业:大公司从实验转向生产后,也想拥有并可靠运行自己的智能。企业是 Baseten 日益重要的方向,把市场扩展到 AI 原生核心之外。
对 Baseten 意味着什么
1 月作者称 Baseten 是"推理界的 Stripe",仍然贴切:Stripe 让支付可编程,抽象掉混乱的金融基础设施;Baseten 对推理做同样的事,部署、自动扩缩、路由、观测、运行时优化、容量、安全和生产支持。但产品在演进:AI 原生公司不会跑在一个模型上,而是数百万个模型驱动的工作流,每个可能最适合不同的模型。因此现在需要完整的模型供应链:带来任何模型,用私有数据和评估后训练,跨硬件和云部署与自动扩缩,路由与观测,再把生产轨迹反馈给下一个版本。这个闭环是 AI 原生公司需要的,几乎没有人想自建:他们不想要一个 100 人的 GPU 平台团队去谈配额、调内核、拼凑五家供应商。他们想构建自己的产品,Baseten 让他们做到。
№ 22 2026-08-23 1,377 词
在斯坦福教 AI 经济学的收获
What I Learned Teaching the Economics of AI at Stanford
副题:以及明年打算改进什么!
阅读英文原文 ↗
BLUF · 一句话概要 作者 2026 年春在斯坦福讲授 MS&E 435《AI 超级周期的经济学》,九周、约 150 名学生、10 位嘉宾。最大收获:没人做空 AI,每个空头都是相对于堆栈中相邻的一层;NVIDIA 和电力最受宠;开源靠"蒸馏不可阻挡"持续逼近前沿,应用厂商应玩"棘轮"把便宜查询路由到开源模型。
开场
作者教这门课犯了一个战术错误:请了 Ali Ghodsi。他一分钟内就提醒全班,作者的团队 2017 年以 9.7 亿美元估值错过了 Databricks。"我们还是朋友。不知怎么的……"
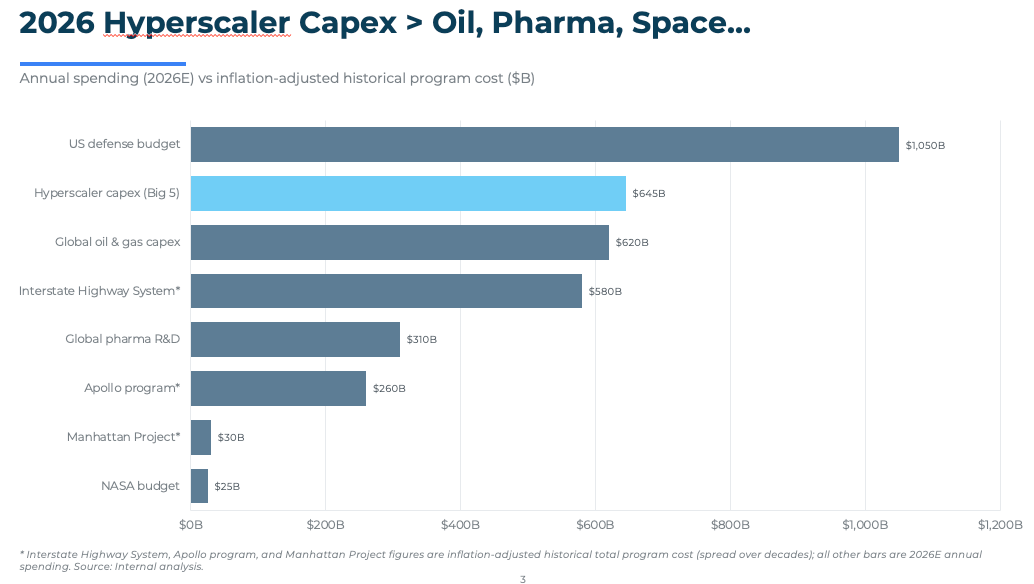
课程概况:一学分、九周、约 150 名学生、10 位嘉宾。AI 超级周期是迄今最大的技术项目,也许很快成为人类历史上最大的单一项目;目前年度 AI 资本开支仅次于美国国防开支。
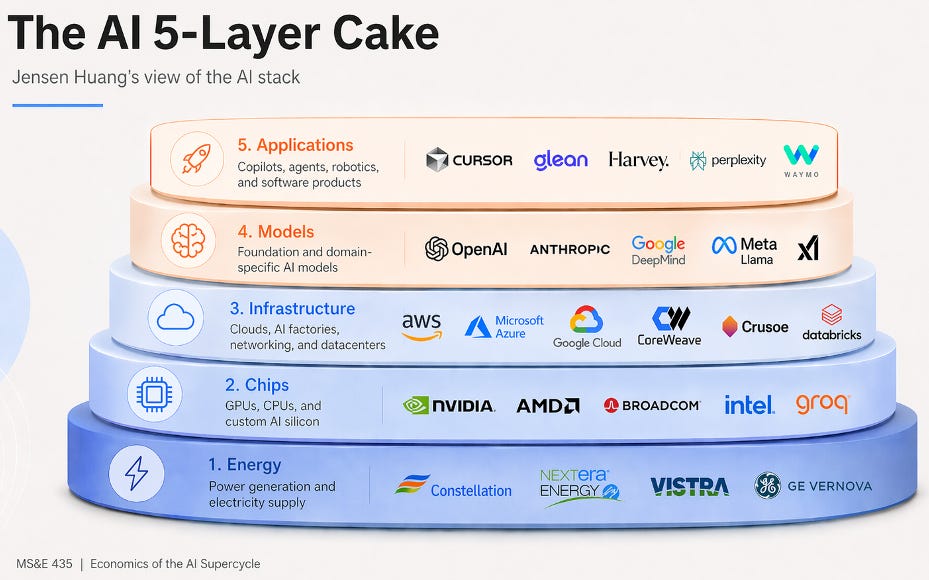
原文配图 年度 AI 资本开支与美国国防开支对比课程前提很简单:按 Jensen 的五层蛋糕(能源、芯片、基础设施、模型、应用),每层与一位一线从业者辩论该层最大的问题,顺着钱在堆栈中流动。
原文配图 MS&E 435 课程与 Jensen 的五层蛋糕对话已开源到 YouTube 播放列表。这是作者当年做工程学生、思考人生方向时希望能上的课,十几年后有机会把这些对话带回校园。"一半人要去创办 AI 公司,另一半要去投资它们,他们至少该知道钱去了哪里。"作者说教的比学的少,不断翻看与从业者对话的笔记,于是分享一份综合。
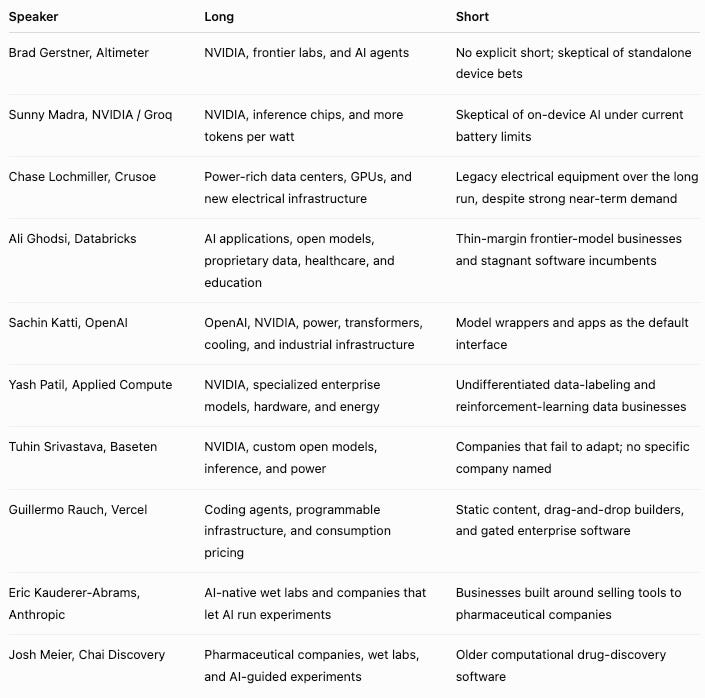
每位嘉宾的多头与空头
原文配图 每位嘉宾的多头 / 空头一览表课程中信息密度最高的收获,是一张"每位嘉宾做多什么、做空什么"的表。当然要去掉嘉宾自身在堆栈中位置的偏见,但即便如此,趋势很明显。两点跳出来:没有人做空 AI;每个空头都是相对于另一个玩家,通常是堆栈中相邻的那一层。Sachin Katti(模型层)做空应用层;Ali Ghodsi(基础设施层)做空模型层。
NVIDIA 最受宠,物理基础设施紧随其后
九场中至少六场出现看多 NVIDIA 或 GPU 的观点。Brad Gerstner 选 NVIDIA 为第一家 10 万亿美元公司,Sachin Katti(OpenAI)给出同样答案;Yash 在承认定制芯片威胁的同时仍看多 NVIDIA;Tuhin 反复回到 CUDA 的强大和与之竞争的困难。这些人视角各异,有投资者、客户、分发伙伴,尽管有多个可信的竞争者,他们都承认 NVIDIA 的主导地位。第二受宠的是电力。Chase Lochmiller 说得最好:AI 数据中心不是装满 GPU 的建筑,而是涉及电力、冷却、光纤、变压器、混凝土和劳动力的巨型建设项目。Sachin Katti 同样看好美国已经忘记如何建造的那部分工业栈。
开源 AI 的奇特案例
三个最大的问题:前沿 AI 这么贵,开源模型能好吗?如果能,为何持续处于前沿的前沿?开源改进后谁拿走经济利益?Ali Ghodsi 的框架最锋利:
开源的表现 :开闭差距现在以周计。Moonshot 在课前两天发布了新的 Kimi 模型,Ali 说它若在 1 月发布"会是有史以来最好的模型,无论前沿与否",它 4 月才出。三周后 Tuhin 给出独立数字:开源落后前沿约 90 天,成本低 70–90%。为何可能:蒸馏不可阻挡 。2022 年的互联网约有 2 万亿 token 训练数据,Ali 的粗算是各实验室此后生成了约 1 万个 Common Crawl 量级的输出,以每百万 token 约 1 美元出售。当产品以 token 形式交付,你无法禁止复制。他直指实验室的矛盾:不能一边游说禁止蒸馏,一边声称没人能复制一位诺贝尔奖得主,二选一。作者说这是课上最大的个人顿悟。谁拿走经济利益:棘轮 。把打到你应用的最笨的 10% 查询路由到便宜的蒸馏开源模型,毛利改善而产品不变;再推到 20%、40%、60%。每个应用厂商都该这么玩。剩下的是以薄利规模化出售前沿智能。餐厅的比喻是请三星主厨煮意面:餐厅只有五个客人时你会这么做,有五百万客人时就不会了。作者的结论:AI 是正和的,开源和闭源都有位置,不是零和。
原文配图 开源与闭源模型的正和格局开源不需要在每个基准上打败最好的模型,只需要对越来越大份额的实际工作足够好、足够便宜、足够可定制。
明年会怎么改
最记挂的是批评性评价:"工程师需要比 40 分钟高层讨论更深的内容。"深度是最公允的反馈。毕竟这是一学分的课程,中位学生每周含上课只花两小时。可以改成三学分,也许某天;眼下想在现有形式下更实质,同时对时间投入保持现实。积极面:学生反馈很友善。讲座系列为激励而优化,激励是真实的:有学生说这门课影响了暑期实习决定,有人终于做了拖延已久的项目,有嘉宾从学生中招到了优秀的人。行之有效的做法:每次课后与嘉宾的小型晚餐,学生在评价中反复引用为选课的理由;多空游戏,把被动听讲变成做笔记;工具额度(OpenAI 的 Codex、Vercel 的 v0),学生在期末项目中真正用上了。
致谢 Ashish Goel 和 Pamela Hinds 支持开课,Chloe Feng 维持运转,制片人 Dan 把课程带出教室;以及十位嘉宾:Brad Gerstner、Sunny Madra、Chase Lochmiller、Ali Ghodsi、Sachin Katti、Yash Patil、Tuhin Srivastava、Guillermo Rauch、Eric Kauderer-Abrams、Josh Meier。课程录像和阅读清单在 mse435.stanford.edu。